资源介绍
视频数量:40个
总时长:3小时32分
课程介绍:
精通日志可视化分析:ELK Stack 核心工具实战指南
想象这样一个场景:凌晨三点,系统突然报警,你被叫醒打开电脑,面对的是一个终端窗口里疯狂滚动的日志文件。几百万行文字,密密麻麻的数字和错误码,你试图用 grep 搜索关键词,但翻来覆去还是找不到问题的根源。这种"日志地狱"是很多运维工程师和后端开发都经历过的噩梦。
日志本身是系统运行最真实的记录,但当数据量从几百条变成几百万条、从单台机器变成上百个节点的时候,肉眼翻阅和简单的文本搜索已经完全不够用了。这时候你需要的不只是一个能存日志的地方,更是一套能让你看清数据规律、快速定位异常、甚至提前预判风险的工具集。
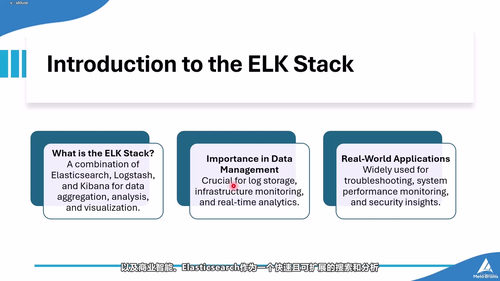
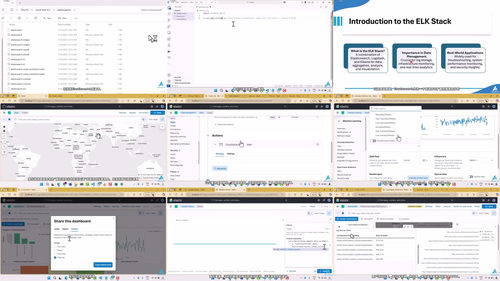
这套课程要讲的就是这个领域最主流的解决方案:Elasticsearch、Logstash 和 Kibana 这三件套。它们三者各有分工,又紧密配合——Elasticsearch 负责海量数据的存储与检索,Logstash 负责把各种来源的日志收集起来并整理成结构化数据,Kibana 则把这些数据变成直观的图表、仪表盘,甚至能自动帮你发现异常。三个半小时,四十个视频,从零开始带你走完这条完整的技术路径。
一、认识 ELK 技术栈
课程的第一章是入门部分,先帮你建立起对整个技术栈的整体认知。为什么要用 Elasticsearch?它和传统数据库有什么本质区别?Kibana 在整套架构中扮演什么角色?这些看似基础的问题,其实决定了你后面能不能真正用好这套工具。
讲完背景之后,课程会带你一步步把 Kibana 装起来,把环境配置好。很多新手会在这一步卡住——版本不兼容、依赖缺失、配置文件不知道改哪里——课程里都有清晰的演示。装好之后,Discover、Visualize、Dashboard、Management 这几个核心界面都会被逐一过一遍,让你对 Kibana 的操作逻辑有个直观印象。
二、用 Logstash 把数据送进 Elasticsearch
光有 Kibana 还不行,里面得有数据。第二章讲的就是如何用 Logstash 把外部数据导入到 Elasticsearch 中。
Logstash 最大的特点是它有一个清晰的三段式管道:输入、过滤、输出。你只需要写一个配置文件,就能把零散的、格式各异的日志整理成统一的结构化数据,再送到 Elasticsearch 里去。课程里会详细演示配置文件的写法,包括常见的过滤器插件怎么用、字段怎么解析、时间戳怎么格式化。
最实用的一节是把系统日志导入 Elasticsearch 的完整流程。你会看到从原始的 Linux 系统日志,到经过 Logstash 处理后变成可以查询分析的结构化字段,整个过程是怎么跑通的。这一章走完之后,你就掌握了从零搭建一条数据通路的能力。
三、在 Kibana 里探索和搜索数据
数据进来了,下一步就是怎么用。第三章聚焦在 Kibana 的 Discover 功能,教你如何浏览索引、理解字段类型。
搜索是 Kibana 最核心的交互方式。课程会同时讲 Lucene 查询语法和 KQL 这两种搜索方式。Lucene 语法灵活强大,适合复杂查询;KQL 则更直观易用,适合日常分析。除了基本搜索,你还会学到如何保存常用搜索、如何按时间窗口分析数据、如何创建脚本字段和运行时字段来处理那些原始日志里没有但你又需要的信息。
这一章的训练会让你从一个"只会用搜索框"的人,变成一个能在海量数据里精确定位任何信息的分析者。
四、用图表让数据说话
数字本身是冰冷的,但变成图表之后,规律就一目了然了。第四章是课程里视觉冲击力最强的一部分。
Kibana Lens 是目前最推荐的图表创建方式,它通过拖拽和下拉菜单就能生成柱状图、折线图、饼图、指标卡等各种可视化元素,几乎不需要写代码。课程会先带你熟悉 Lens 的所有选项和配置技巧。
然后是 Vega,这个更进阶的可视化语言。如果你需要做一些 Lens 没法直接实现的复杂图表,比如自定义的拓扑图、桑基图等,Vega 就派上用场了。课程会用实际案例演示 Vega 的写法。
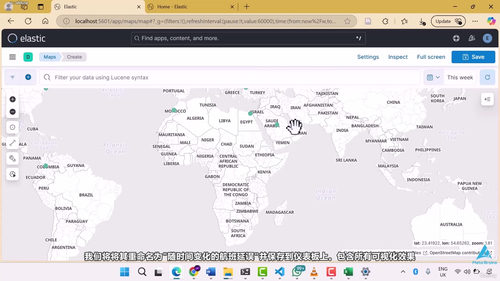
时间序列分析有专门的 Timelion 工具,它用一种类似数学表达式的语法来做时间维度的深度分析,非常适合监控指标类的数据。地理信息可视化也是一大亮点,课程会教你如何创建地图可视化,把 IP 地址、地理位置这些字段映射到地图上。配合最佳实践的讲解,你能学会什么样的数据该用什么样的图表来呈现。这一章的最后一节,会把所有零散的图表组合成一个完整的多图表仪表盘,第一次让你看到一个真正像样的分析界面长什么样。
五、打造专业级的仪表盘
第四章是创建图表,第五章则是把这些图表组织成一个真正可用的仪表盘。
一个好的仪表盘不是图表的简单堆砌,而是有设计逻辑的。课程会从"如何设计一个有效的仪表盘"这个问题开始讲起,包括布局原则、信息层级、配色方案等。然后会演示如何整合多个索引模式,把不同来源的数据放在同一个仪表盘里做交叉分析。
交互性是仪表盘区别于静态报表的关键。课程会教你添加过滤器、下钻链接,让用户能在一个仪表盘上层层深入探索数据。性能优化也会单独拿出来讲,因为数据量一大,仪表盘加载变慢是常见问题。最后还会讲一个非常实用的功能:如何把做好的仪表盘嵌入到外部的应用系统中,比如公司内部的运维平台、管理后台等场景。
六、让系统主动告诉你哪里出了问题
数据可视化的下一步,不只是"看",还要"被通知"。第六章讲的是 Kibana 的告警和报表功能。
你会学到如何配置告警规则,设置触发阈值。比如当某个接口的错误率超过 5%,或者某个服务器的 CPU 使用率持续十分钟高于 90%,系统就会自动触发告警。告警可以通过邮件发送,也可以写入指定的索引供后续处理。Elasticsearch 自带的 Watcher 组件也会讲到,这是一个更底层的告警引擎,适合需要复杂判断逻辑的场景。
这一章的意义在于,你不再需要每隔一段时间就去手动刷仪表盘看数据,而是让系统在异常发生的第一时间主动通知你。
七、权限管理与安全控制
数据可视化往往涉及敏感信息,谁能看什么数据必须严格控制。第七章讲的是 Kibana 的安全机制。
Spaces 是 Kibana 用来隔离不同团队工作空间的功能。比如开发团队有自己的仪表盘空间,运维团队有另一个,彼此不干扰。课程会演示如何创建和配置 Space。基于角色的访问控制(RBAC)则是更细粒度的权限管理。哪些角色可以访问哪些索引、哪些角色可以编辑仪表盘、哪些角色只能查看,这些权限策略怎么配,课程都有详细的操作步骤。学完这一章,你就能把一套完整的权限体系搭起来,既保证数据安全,又不影响协作效率。
八、用机器学习发现隐藏的异常
这是课程中最"智能"的一章。Elasticsearch 内置了机器学习功能,Kibana 里有专门的界面来使用它。
你会学到如何创建一个机器学习任务,让系统自动分析时间序列数据,找出那些不符合正常模式的异常点。比如某个 API 的响应时间突然飙升、某个地区的订单量异常下跌,这些情况机器学习都能自动捕捉。课程还会教你如何对机器学习任务进行定制化配置,让它更贴合你的具体业务场景。预测功能也是重点,你可以让系统基于历史数据预测未来的趋势,这在容量规划和异常预警中非常有用。这一章把整个课程从"看数据"提升到了"让数据自己思考"的层次。
九、综合性实战项目
最后一章是一个完整的实战项目,把前面学到的所有技能串起来用一遍。
你会跟着课程一步步完成这样的流程:把数据导入 Kibana,进行探索和搜索,创建各种可视化图表,组合成专业仪表盘,配置下钻和告警规则,加上权限控制,最后用机器学习做异常检测和预测。这个项目不是孤立的练习题,而是一个接近真实工作场景的完整案例。学完之后,你就具备了独立搭建一套日志可视化分析系统的全部能力。
运维工程师是这门课最直接的受众。如果你经常需要在半夜处理告警、面对一堆日志无从下手,这套课程能帮你彻底改变工作方式。后端开发同样会从中受益——给自己的应用加上结构化的日志输出和可视化分析能力,会让你在排查问题时效率翻倍。数据分析师会发现它的独特价值,ELK 技术栈处理的是真实业务场景下的海量数据,和你平时用的 BI 工具在思路上有很多相通之处,却能处理大得多的数据量。
学完这套课程,你最大的收获不是记住了多少个按钮和配置项,而是建立了一种用数据驱动运维和开发的思维方式。当系统再出问题的时候,你不再需要埋头翻日志文件,而是打开仪表盘,扫一眼图表,问 KQL 几个问题,就能快速定位问题所在。这种能力,在数据量越来越大的今天,会变得越来越不可或缺。