资源介绍
视频数量:24个
总时长:1小时31分
课程介绍:
Informatica PowerCenter数据集成实战精讲
想象一下这样的场景:你所在的公司每天产生上百万条交易数据,这些数据散落在Oracle数据库、ERP系统、平面文件、甚至云端SaaS应用里。老板突然问你,能不能把这些数据汇总到一起,做一份全公司统一的销售分析报表?你打开电脑,面对的却是一堆格式各异、口径不一的原始数据,根本无从下手。这就是企业数据集成要解决的问题——把碎片化的数据梳理成统一的、可供决策分析的信息资产。
这门课就是为解决这个问题而来的。Informatica PowerCenter是全球企业级数据集成领域使用最广泛的工具之一,它做的事情就是把不同来源的数据抽取出来,经过清洗、转换,最终加载到数据仓库或数据集市里,形成可供分析的标准数据模型。整个课程只有24个视频、总时长一个半小时出头,但内容安排紧凑,从基础架构到高级转换再到工作流调度,层层递进,适合想在短时间内建立完整PowerCenter知识体系的学习者。
一、数据集成与PowerCenter核心架构
课程的第一部分先帮你建立全局认知。第一个视频讲ETL架构,也就是提取、转换、加载这套方法论——为什么数据不能直接从源系统搬到数据仓库,中间需要一层暂存区?为什么提取阶段必须不影响源系统的日常事务处理?这些底层逻辑搞清楚了,后面学具体操作才不会只知其然不知其所以然。
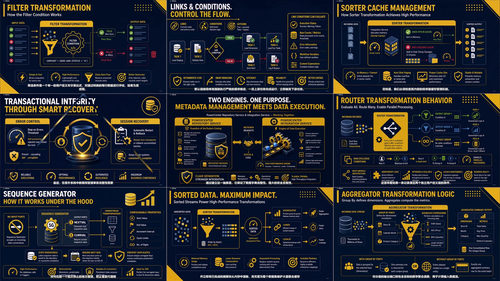
接下来会介绍PowerCenter在企业数据仓库中的定位,以及它的核心组件构成。PowerCenter并不是一个简单的工具,它由多个服务协同工作:域(Domain)是最高级别的管理单元,节点(Node)承载具体的服务进程,而集成服务(Integration Service)负责执行数据转换任务,存储库服务(Repository Service)则管理元数据和对象版本。理解这些组件之间的调用关系,是后续排查性能问题和配置多节点环境的基础。
二、数据源与目标设计
搞清楚架构之后,课程进入实际操作层面。这一部分聚焦于数据流的两端——从哪里读数据、写到哪里去。
你会学到如何定义源系统,特别是关系型数据库中的表结构。课程也会讲到平面文件的处理,比如定界符文件如何解析、字段类型如何识别。很多企业的数据集成场景里,合作伙伴传来的CSV或TXT文件是常见的数据源,掌握这一块非常实用。
目标端的设计同样有讲究。批量加载和实时加载的策略选择、主键约束的处理、增量更新与全量覆盖的差异,这些细节都会影响最终数据仓库的数据质量和加载效率。
Mapping Designer是PowerCenter中最常用的客户端工具,课程会带你认识它的整体布局和基本操作逻辑。源限定符(Source Qualifier)这个组件尤其重要——它不仅负责从源系统读取数据,还在数据进入转换管道之前自动完成原生数据类型到PowerCenter内部转换类型的映射。理解这个映射机制,能帮你避免很多因精度丢失或字符截断引发的隐蔽bug。
三、转换逻辑基础:主动与被动转换
课程第三部分进入转换(Transformation)的核心内容,这是PowerCenter开发的灵魂所在。
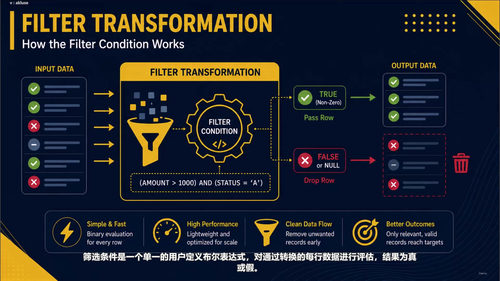
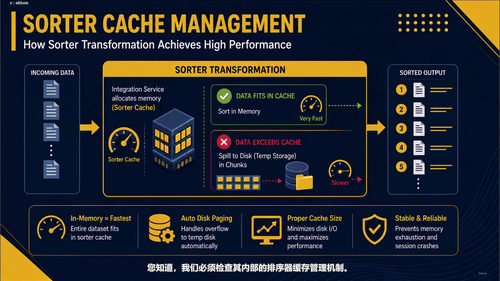
首先必须搞清楚一个概念:主动转换和被动转换的区别。这个分类直接决定了集成服务如何分配内存、如何路由数据流,以及如何执行管道。简单来说,被动转换不改变通过它的行数和行顺序,比如表达式转换做行级计算、查找转换返回单行匹配结果;而主动转换会改变行数或行顺序,比如过滤器丢掉不符合条件的行、排序器重新排列数据顺序。
这个区别为什么重要?因为如果在一个映射里错误地组合了主动和被动转换,管道验证时就会报错,或者在批量运行时产生意料之外的数据异常。课程会用具体的例子帮你建立直觉,明白什么时候该用哪种转换。
这一部分还会逐一讲解几个基础但高频使用的转换:表达式转换负责行级计算,比如拼接字段、做数学运算;过滤器转换按条件分流数据;排序器对数据流排序;路由器则可以把数据按多个条件分发到不同路径,比过滤器更灵活。这些转换是后续构建复杂映射的基石。
四、高级数据转换策略
基础转换掌握之后,课程进入进阶部分,介绍几种处理复杂业务场景的高级转换。
聚合器转换用来做分组汇总,比如按地区统计销售总额、按月份汇总订单数量。这里会涉及分组端口、聚合端口、排序端口的区别,以及增量聚合与全量聚合的性能差异。
连接器转换用于合并来自不同来源的异构数据。比如你有一份来自数据库的客户基本信息,又有一份来自平面文件的交易明细,连接器可以按照某个键把它们拼接在一起。课程会讲清楚连接类型的选择(普通连接、左右连接、全连接),以及排序连接与无排序连接的性能权衡。
查找转换是PowerCenter里使用频率极高的组件之一。它用来引用参考数据,比如在做客户地址标准化时去匹配省份代码,或者在数据清洗时校验某列是否在合法值列表里。这一节还会讲缓存管理——查找表的数据可以缓存在内存里以提升性能,不同的缓存策略(共享缓存、未缓存、静态缓存)适用于不同场景。
序列生成器用来产生唯一递增的编号,常用于代理键的生成。标准化器则把多列数据展开成多行,或者反之把多行合并成列,是一种行列转换的利器。
更新策略转换负责决定每一条记录在目标端的处理方式——是插入新行、更新已有行、标记删除,还是直接拒绝。这部分会讲DD操作的具体配置方法,以及如何配合会话属性实现批量提交。
五、工作流执行与系统管理
最后一节聚焦于工作流(Workflow)的设计与调度。映射只是定义了数据转换的逻辑,真正要让数据动起来,还需要把映射包装成会话任务(Session Task),然后用工作流管理器编排多个任务的执行顺序。
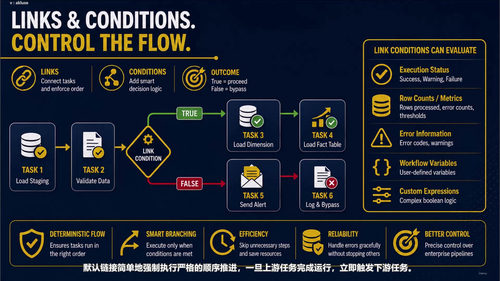
课程会讲工作流管理器的基本架构,包括任务、链接、工作流等概念。链接条件(Link Conditions)是控制流程走向的关键——比如只有会话A执行成功才执行会话B,失败则发邮件告警并跳转到错误处理任务。这种条件分支能力是构建健壮批处理系统的基础。
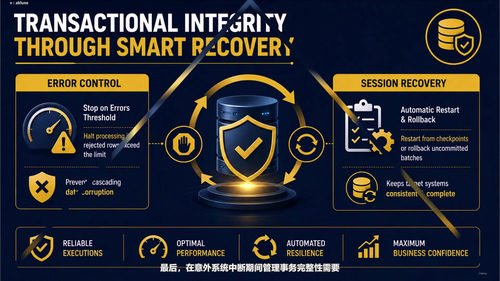
会话任务的属性配置内容非常多,包括内存分配、缓冲区大小、提交策略等。课程重点讲解提交策略,也就是每处理多少条记录就向目标提交一次。提交频率过高会影响性能,过低则会增加回滚时的代价,需要根据数据量和业务容忍度做权衡。
参数文件和变量管理是最后一个知识点。在企业环境中,同一套映射往往要跑在开发、测试、生产三个环境里,每个环境的数据库连接信息可能都不一样。如果把连接信息硬编码到映射里,每次迁移都要改一堆地方。参数文件就是用来解决这个问题的——把可变的配置抽离到外部文件,映射在运行时动态读取。这种做法让映射具备了良好的可移植性和环境隔离能力。
整体来看,这门课覆盖了PowerCenter开发的核心知识面,从架构认知到映射设计再到工作流调度,环环相扣。它特别适合以下几类人:正在准备PowerCenter认证考试的在校学生或转行人士;刚入职需要快速上手项目的数据工程师;以及有一定SQL基础但没接触过企业级ETL工具的数据库管理员。课程节奏紧凑,没有冗余的废话,一个半小时就能搭建起完整的知识框架,后续在项目里遇到具体场景时可以随时回来查阅对应章节。