资源介绍
视频数量:17个
总时长:2小时30分
课程介绍:
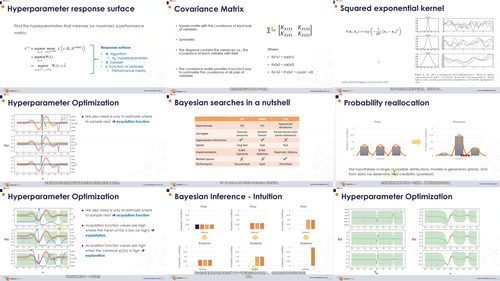
超参数调优进阶:贝叶斯优化与TPE算法实战
你训练了一个深度学习模型,跑了三天三夜,显卡烧得嗡嗡响,结果准确率死活卡在86%上不去。换了一批超参数重新训练,又过了两天,准确率反而变成了84%。盯着屏幕上那一串数字,你开始怀疑人生——到底是自己调参的姿势不对,还是这个模型根本就没什么潜力可挖?
这就是很多机器学习从业者都会撞上的墙:超参数怎么调,好像全凭运气。网格搜索像撒网捕鱼,随机搜索像买彩票,能不能抽中大奖全看天意。可问题是,真实的机器学习任务里,一次训练可能就要几小时甚至几天,你根本没有本钱去"广撒网"。两小时三十分钟的课程,专门解决的就是这个让人头疼的问题——怎么用更少的试验次数,找到更好的超参数组合。
一、超参数优化的基本逻辑
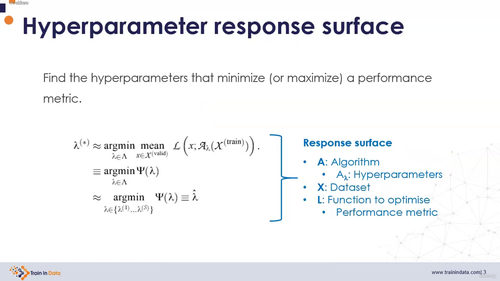
课程从一个大家熟悉但可能没深究过的概念讲起:顺序搜索。讲师会先帮你把超参数响应面这个抽象概念具象化——它本质上就是把不同的超参数组合映射到模型性能上的一个曲面。为什么这个曲面是一个无法求导的黑盒函数?为什么传统的梯度下降在这里行不通?只有在理解了这一点之后,你才能真正明白为什么我们需要比暴力搜索更聪明的策略,以及"利用已有好结果"和"探索未知区域"之间为什么要做权衡——这两件事听起来都重要,但资源有限,你必须有所取舍。
二、贝叶斯优化的数学地基
这是整个课程最硬核的部分,也是最值得花时间啃的部分。讲师会带你从最基础的贝叶斯推断开始,一路爬到高斯过程。
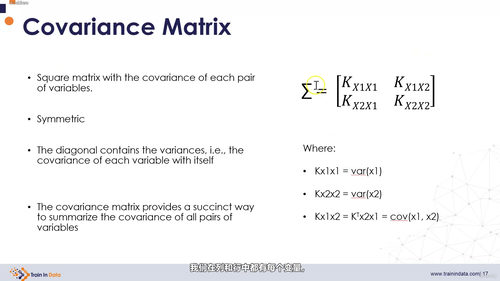
先讲联合概率与条件概率,再推导出贝叶斯定理——这是后面所有内容的基石。贝叶斯定理本身并不复杂,它提供的是一种"用新证据更新原有信念"的思维方式。然后是高斯分布,从一维讲到多元高斯分布,搞清楚为什么这个钟形曲线能成为贝叶斯优化的核心工具——因为它不仅能给出预测值,还能告诉你对这个预测有多大信心。这种"带着不确定性做决策"的思路,是整个贝叶斯优化的灵魂。
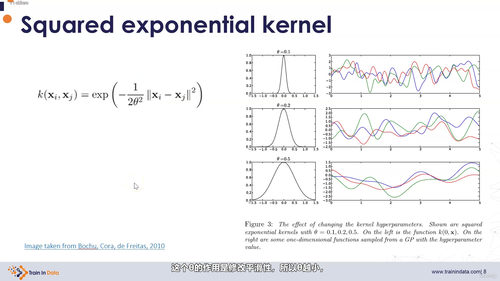
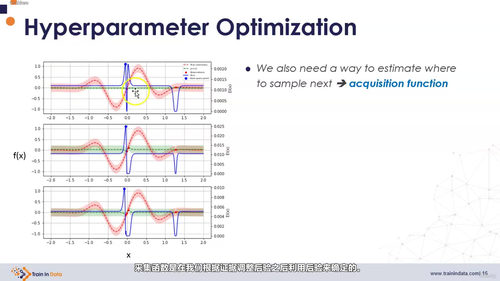
接下来是高斯过程与核函数。你会明白高斯过程是怎么根据已知的几个观测点去"猜测"未知区域的函数形态的,而不同的核函数决定了它猜测的方式:是平滑的、周期性的、还是带有某种特殊的局部结构。最后是采集函数,这是决定"下一个该试哪个超参数组合"的大脑,它在"挑已知的好区"和"探未知的新区"之间不断做平衡,是贝叶斯优化"既精明又好奇"的关键所在。
三、SMBO框架:把零散的零件拼起来
讲完各个组件之后,课程会告诉你这些零件是怎么组成一台完整机器的。SMBO,也就是基于序列模型的优化,是一个统一的框架,把代理模型、采集函数、迭代更新这些环节串成一条流水线。学完这部分,你脑子里会有一张完整的流程图,不再是零散的知识点,也能够看懂Optuna、Hyperopt这些主流工具的源码在干什么、为什么要那样设计。当工具出问题时,你知道该去哪里排查,而不是只能对着报错干瞪眼。
四、TPE与SMAC:另辟蹊径的优化方法
贝叶斯优化不是唯一的聪明办法。课程后半段重点介绍TPE,也就是树形Parzen估计器,这是一种完全不同的思路。它不再建模"超参数对应的损失是多少",而是建模"好的超参数长什么样、差的超参数长什么样",然后根据这两个分布的比例来选择下一步的采样点。这种基于密度估计的方法在某些场景下比高斯过程更灵活,训练速度也更快,在工业界被广泛使用——你常用的Optuna默认采样算法其实就是TPE。
你会学到TPE的完整流程、超参数如何配置,以及它和随机搜索相比究竟快在哪里、好在哪里。同时讲师还会介绍SMAC,也就是基于序列模型的算法配置,让你看到同一个问题可以有多少种不同的解法,扩展你的思路。课程最后还会专门对比贝叶斯优化和随机搜索的效率差异,用直观的例子告诉你为什么"聪明的搜索"真的能省下大量时间。
五、最后的一些话
学完这门课,你不会只是又学会调用一个API。你会真正理解那些主流自动调参工具背后在跑什么算法,为什么有时候它能帮你找到意想不到的好参数,有时候又会卡在某个局部最优里出不来。当你下次再面对那个死活上不去的86%准确率时,至少你知道该往哪个方向使劲,而不是再靠运气盲猜。
如果你是机器学习工程师,已经在用XGBoost、LightGBM或者深度学习模型,但苦于调参效率太低、训练成本又太高,这门课会帮你打开一扇新大门。如果你是数据科学家,想把模型性能再往上推一两个百分点,里面讲的那些理论也会让你在和同事讨论时更有底气、更有方向感。课程对数学有一定要求——至少要能看懂基本的概率论公式——但讲师讲得并不晦涩,跟着节奏一步步走下来,问题不大。课程还附带了补充阅读材料,方便学完之后继续深入。