资源介绍
视频数量:18个
总时长:2小时46分
课程介绍:
机器学习模型可解释性实战:从博弈论到沙普利值完整掌握
你有没有过这样的经历:辛辛苦苦训练了一个效果不错的机器学习模型,老板或者业务方紧接着来一句"这个模型为什么给出这个预测?",你瞬间语塞。明明准确率还挺高,可就是说不出个所以然来。
这其实是机器学习领域里一个老大难的问题。模型越复杂、预测越准,解释起来反而越费劲。就像一个黑盒子,你往里面扔数据,它吐给你结果,可中间发生了什么,你一无所知。在金融风控、医疗诊断、信贷审批这些场景里,业务方不光要看你预测得准不准,更想知道"为什么"。
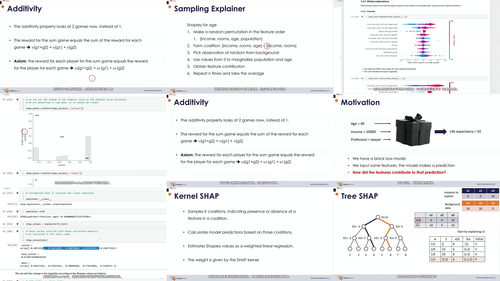
这门课就是来解决这个问题的。整个课程围绕沙普利值和加性解释方法展开。沙普利值原本来自合作博弈论,最初是用来解决"一群人合作赚了钱,怎么公平分配收益"这个问题的。把这个思路搬到机器学习里,意思就变成了:模型给出了某个预测,每个特征各自贡献了多少?这样一来,黑盒就被打开了,每个特征的影响一目了然。
课程一共18个视频,总时长不到三小时,结构紧凑,讲练结合。
一、基础铺垫
课程会先讲清楚为什么要用沙普利值来解释模型。假设你有一个预测房价的模型,输入包括年龄、收入、人口密度、房间数这些特征,模型输出一个房价数字。你不光想知道预测结果,更想知道:是收入影响最大,还是房间数拖了后腿?搞清楚特征贡献,在调参、做特征选择、跟业务方沟通时都极其重要。
二、博弈论直觉
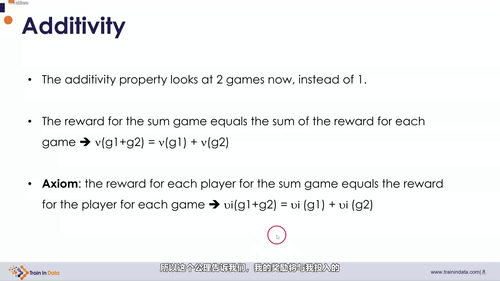
沙普利值之所以能用在机器学习上,是因为它满足几条数学公理,是"公平分配收益"的唯一解。课程会用直观的例子帮你理解这些公理的实际含义,比如效率性、对称性、虚拟玩家不参与分配这些概念。讲解方式比较友好,不会一上来就甩一堆公式让人懵掉。学完这部分,你会真正理解沙普利值是怎么从博弈论里来的,为什么它是"唯一公平"的分配方案。
三、计算方法
沙普利值的精确计算需要遍历所有可能的特征组合,当特征数量为p时,需要检查2的p次方个联盟。这个计算量在特征多的时候会爆炸,所以课程会教你三种不同复杂度的处理办法。
第一种是精确解释器,适合特征比较少的小场景,计算结果非常准确。课程会带着你用Python代码一步步实现,让你看到底是怎么算出来的。
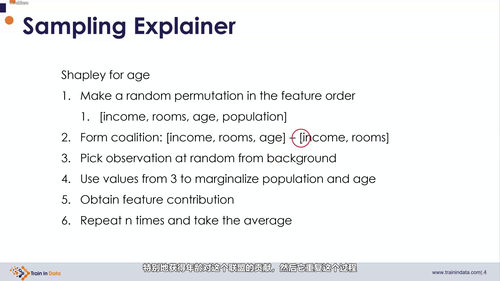
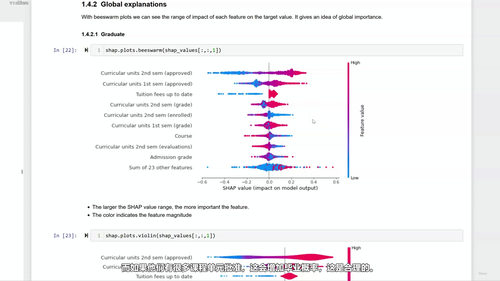
第二种是置换法。这个方法不对所有组合都计算,而是对特征顺序做随机排列,只采样部分组合来估算沙普利值,速度快得多。课程会用学生辍学数据集做演示,这是一个三分类问题,目标是预测某高校学生是入学、毕业还是辍学,用的是XGBoost分类器。从加载数据、训练模型到调用SHAP接口解释预测结果,整个流程都会带你走一遍。
第三种是采样解释器和核方法,适合特征更多、数据量更大的情况。
四、不同模型的应用
不同类型的机器学习模型,沙普利值的计算方式也不一样。课程会专门讲线性模型下的快速算法,包括线性回归和逻辑回归,都有配套的代码演示。决策树、随机森林、XGBoost、LightGBM这些树模型也有专门的TreeSHAP算法,计算效率比通用方法高出一大截,同样配了完整的实战演示。
每个理论讲解后面都紧跟着代码演示,这是这门课很突出的一个特点。不光是听懂了,还能亲手跑一遍。
适合谁来学?如果你平时在用sklearn、XGBoost、LightGBM这类工具做机器学习项目,但经常被"解释性"这个问题卡住,这门课就很合适。数据科学家、算法工程师、需要向业务方汇报模型逻辑的同学,都能从中学到实用的技能。
学完以后,你会拥有一套完整的模型可解释性工具箱。不光能回答"模型做了什么预测",还能精确指出"是哪些特征、通过什么方式影响了这次预测"。这种能力在做特征筛选、排查异常预测、建立业务信任时都特别有用。课程末尾还整理了进阶阅读资源,想继续往某个方向钻研也有迹可循。