资源介绍
视频数量:10个
总时长:2小时8分
课程介绍:
数据分析与数据科学实战
一张学生成绩表摆在面前:姓名、科目、分数都在列里,却有人问“哪些学生需要补考”“各科平均分相差多少”“按班级排名后谁进步最快”。如果只盯着表格逐行翻,答案会越来越难找;如果交给Python,筛选、计算、汇总和排序可以连成一条清晰的数据流程。这套课就从真实的数据问题出发,用十节视频带你搭好分析环境,补齐必要语法,再逐步进入NumPy、Pandas与探索性数据分析。
一、课程地图与学习定位:
课程总时长二小时八分钟,共十节视频,节奏紧凑,内容从环境安装开始,先复习数据分析常用的Python知识,再进入数组计算、数据框处理和实际分析练习。第一节先把知识范围、学习顺序和项目目标摊开,让你知道每一段代码解决什么问题,而不是只照着敲。课程定位在中级起步,适合已经接触过编程,却不熟悉数据处理逻辑的人;零基础学习者可以先熟悉基础语法,再按章节练习。目录还配有题目、练习资料与参考链接,方便把“看懂”变成“做对”。
二、搭建可运行的分析环境:
第二节讲解如何安装Anaconda并启动Jupyter Notebook。Windows、Mac和Linux的安装路径都做了说明,下载、跳过注册、选择系统版本等步骤清楚呈现。装好以后,你会理解Notebook的单元格如何组织代码、运行结果如何保留,以及后续如何导入NumPy、Pandas等库。把环境先理顺,能减少初学阶段大量与数据无关的报错,也能让每个练习都从同一套工作区开始。
三、为数据分析补齐Python基础:
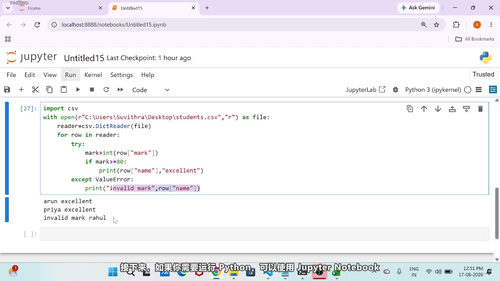
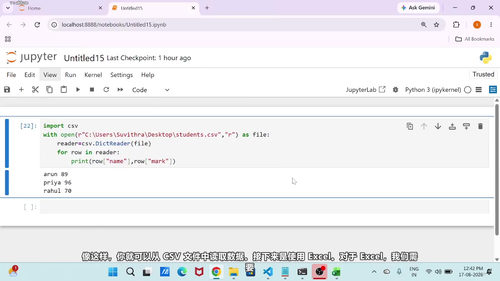
第三、四节不是泛讲一遍编程,而是围绕列表、函数、Lambda表达式、文件读取和表格处理展开。课程用学生部门表与学生成绩表作为练习材料,处理CSV、Excel和JSON等常见数据格式。你会练习创建与筛选列表、使用条件判断组织逻辑、封装可复用函数,并用Lambda完成简洁的映射与筛选。重点是理解原始文件怎样进入程序、数据怎样变成可分析对象,因为这一步决定后面的数组统计与表格操作能否真正落地。两节内容都附带问题与练习,学完可以检查自己是否理解数据读取、函数调用和结果提取。
四、用NumPy处理高速数组运算:
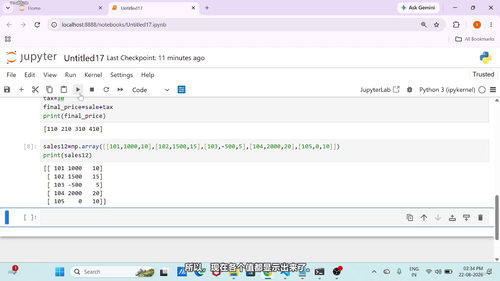
第五、六节从NumPy基础开始,先认识数组、数据类型、维度、形状、索引和切片,再学习向量化计算与广播机制。比如逐个遍历成绩和直接对整列数组求平均,代码量与运行效率差别很大;理解广播后,也能看懂不同形状的数据为什么能够按规则组合。第七、八节进一步转入分析场景,利用均值、中位数、标准差、极值、排序等方法描述数据分布,并通过练习题巩固参数含义。课程强调的不只是算出结果,还包括判断该看哪个指标、怎样解释偏差,以及数组维度或数据范围不一致时该从哪里检查。
五、用Pandas完成真实表格任务:
第九节从Pandas的Series和DataFrame起步,演示如何创建表、导入数据、查看行列与字段,再进行选列、选行和条件筛选。第十节接着处理增删列、改名、排序、排名和值计数。例如,可以根据分数新增结果列,也可以统计科目、班级或成绩区间的出现次数。Pandas的价值在于把杂乱数据整理成结构清晰的数据表:缺失值如何辨认,分组后如何汇总,筛选条件如何叠加,这些都会直接影响统计结论。课程把这些操作放回学生成绩数据中演示,让你逐步形成稳定的数据清洗习惯,而不是记住一串互不相干的函数名。
六、形成可复用的分析流程:
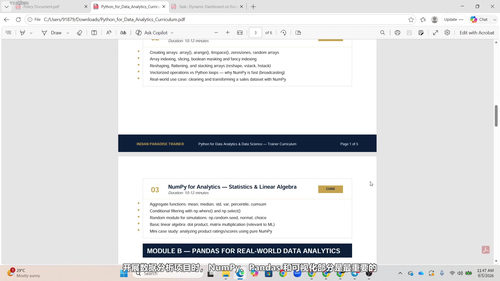
从课程规划来看,NumPy、Pandas、可视化、探索性数据分析、实时数据项目以及PowerBI衔接都属于完整的数据学习路径。实际分析时,流程往往从提出问题开始,接着读取数据、检查质量、清洗字段、计算指标,最后用图表呈现结论并接受业务追问。学生表练习可以成为分析流程的起点:先比较不同科目的整体水平,再查看班级差异,随后追踪个人成绩变化。这样做能训练你解释数据的能力,也能为面试中的数据分析题、概念验证阶段的作品展示准备素材。
学完这套课程,你不只是会调用几个库函数,而是能搭好环境、读入文件、处理数组、整理表格,并沿着明确步骤完成一份基础分析。面对新的数据时,你知道先检查什么、再计算什么、最后怎样表达发现,这正是从“会写代码”走向“能用数据回答问题”的关键跨越。