资源介绍
视频数量:26个
总时长:39分
课程介绍:
第二受众:人工智能代理如何发现和选择商品
想象一个普通夜晚:你准备买跑鞋,打开对话助手,直接问“适合刚开始跑步的人、三百元以内、明天能送到哪里”。助手同时查看品牌官网、商品页、库存和配送说明,比较几款商品后给出建议。你没有亲手点击这些页面,网站日志里却多出了一串请求。过去分析工具盯着人的浏览、购物车和结账,现在机器也在替消费者发现商品、核实事实、筛选购买方案。这就是“第二受众”,它已经出现在服务器日志、网页响应和商业结果里。
课程用二十六个短视频、总计约三十九分钟,聚焦一个实际问题:网站怎样看懂机器请求,它们在做什么,读到了什么,又怎样把机器发现纳入商业判断。内容从概念和流量识别,讲到商品页表达、站点服务,最后落到归因测量。
一、第二受众为何改变电商分析:
传统漏斗通常从搜索或广告开始,经过网站浏览、加入购物车,最后走向付款。人工智能代理把一部分发现和比较搬到了网站之外,消费者不必先点击你的页面,助手就能替你查资料、看价格、核对库存。于是,商品有了曝光,却未必有普通点击;机器读到了页面,也不代表留下了人类会话。课程用训练、回答、索引和实时阅读四种角色解释这种差异,还通过实时仪表板提出关键问题:谁在访问,为什么访问,访问了什么,返回了什么,以及这些信号是否值得继续追踪。
二、识别机器流量,要让证据说话:
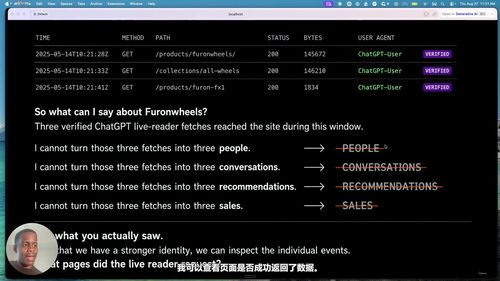
课程从 Applebot、Bing、Google 等常见机器来源入手,重点不是认名字,而是区分观察、得到支持、未知和推测。看到一次请求是观察,出现可重复的证据才接近得到支持,现有材料不足时必须保留未知,想到某种解释也只能先放在推测里。用户代理只是一句自我声明,任何人都能填写“ChatGPT用户”,所以不能凭字段名称判断来源。课程会结合来源地址、平台公布的网络范围、请求路径和时间戳进行核验,也会说明服务器端检查能看到什么,以及实时阅读者究竟取走了哪些内容。Google Analytics 漏掉这类流量并不奇怪,浏览器端规则、会话统计和默认过滤都可能遮住机器请求;服务器看到的抓取次数,也不能直接换算成真人阅读量。
三、人工智能代理读取商品页的六个商业事实:
同一条商品网址,对人和机器可能呈现两种表示。人能凭视觉和交互理解页面,机器更需要明确、稳定、可核验的文字和结构。课程把检查重点落在六类商业事实上,包括商品身份与类目、价格、库存和可购买状态、规格与变体、配送与退换信息,以及商家和信任信息。事实若只藏在图片、脚本或含糊文案里,或者不同页面互相冲突,代理就可能无法比较或给出错误建议。
这六类信息不是装饰性字段,而是代理做比较时真正需要的事实。价格要标明币种和时效,库存要说明是否可购买,规格和变体要彼此对应,配送与退换信息要可查,任何冲突都会让推荐失去依据。
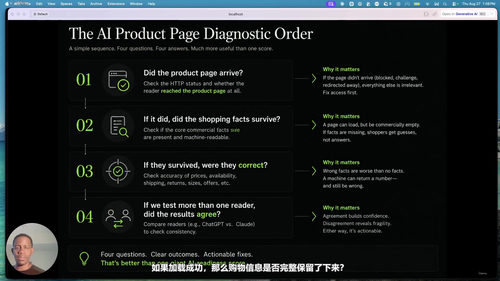
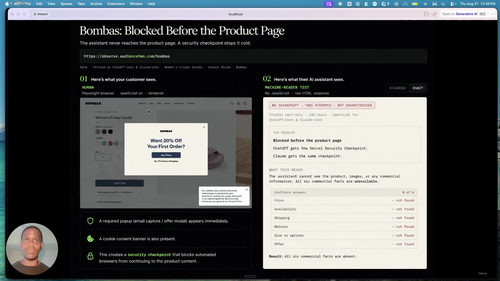
课程用多个品牌和故障案例说明,诊断比一个笼统评分更有用。入口被拦截,机器连页面都打不开;页面显示请求成功,却几乎没有商业内容;页面返回成功但价格错误,都会让机器消费者得到错误结果。课程还整理四种失败模式和排查顺序,带你从访问是否发生、响应是否正确、内容是否完整,到事实是否一致逐层定位。
四、机器界面的两个杠杆:
网站服务机器代理,核心只有两件事:访问与信息。访问决定请求能否到达,信息决定到达后能否读懂。只放开抓取,解决不了页面贫乏;只堆内容,也弥补不了错误拦截。训练、索引和实时阅读各有目的,站点应结合日志、状态码、路径和返回内容,判断哪些请求允许、限速、缓存或进一步验证,让机器接口既可用又可追踪。
五、从机器发现到商业结果:
当消费者在对话框里完成发现,外部助手可能成为新的入口,传统点击归因很容易漏掉这段旅程。课程最后串起从身份核验到业务信号的测量链:确认请求身份,记录访问路径和时间,查看网页实际返回,再追踪推荐、引流、辅助转化和成交证据。测量时,可以把已核验身份、实时阅读请求、页面路径、返回内容、外部推荐和后续信号分层记录,区分直接成交与辅助影响,避免只盯最后一次点击。能观察到的内容和暂时无法确认的部分要分开,一次机器引用也不能直接等同于销售额。
这套方法适合电商负责人、增长与搜索团队、网站分析人员、商品内容编辑,以及负责日志和爬虫策略的技术人员。它尤其适合已经看到陌生代理请求,却不知道那是训练、索引还是实时阅读的人。学完后,你可以从用户代理追到来源证据,从返回成功追到商品事实,再从页面读取追到业务信号,在传统漏斗之外建立更可靠的第二受众测量视角。