资源介绍
视频数量:77个
总时长:4小时3分
课程介绍:
机器学习三大范式与智能结对编程
同一份泰坦尼克数据,用来训练时,模型预测乘客生还率几乎次次命中;换到另一批乘客身上,判断却明显失灵。问题出在数据质量、算法选择,还是对误差的理解?课程从这个常见的“实验室里很好用,真实场景里却不好使”的场景出发,带你把机器学习从一组可运行代码还原成一套能解释、能判断、能改进的方法。
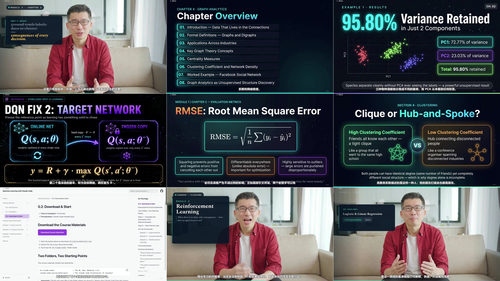
课程共有77个视频,总时长4小时3分,结构分为监督学习、无监督学习和强化学习三大模块。每条主线都配有讲义、实验文档和数据集,另有配套网站与 Claude Code 结对编程环节。你会一边理解统计原理,一边动手分析泰坦尼克、贷款、葡萄酒、大学、论文、社交网络和航班等数据,最后形成清晰的问题拆解与算法选择习惯。
一、从估计理论理解模型:
第一模块先讲估计是什么,以及估计量的偏差、方差、均方误差、一致性等性质,再比较三类经典估计方法,并把这些概念接到机器学习。这样做的价值很直接:你看到的每个模型都不再只是公式,而是一个对未知函数的估计。偏差与方差、欠拟合与过拟合、维数灾难、交叉验证、集成方法和评估指标会连成一条线,帮助你判断模型为什么好、又会在什么地方失效。
二、掌握监督学习的算法与评估:
在算法部分,课程依次讲解逻辑回归、支持向量机、决策树与随机森林、朴素贝叶斯、K近邻和线性回归,并加入特征选择。你会看到分类与回归任务各自适合什么情况,也会学会用准确率、精确率、召回率等指标检查结果,而不是只追逐训练集上的漂亮分数。实验使用泰坦尼克、贷款和葡萄酒数据集,适合练习从数据准备、模型建立到结果评估的完整流程。
三、在没有答案的数据中发现结构:
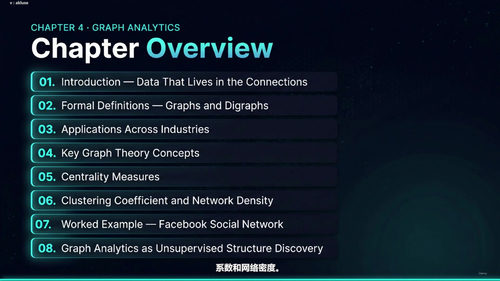
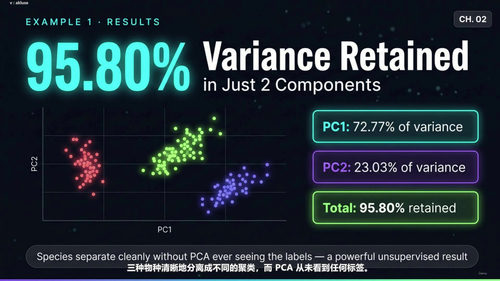
当数据没有现成标签时,无监督学习会从数据里寻找结构。聚类部分先讲基本概念和K均值算法,再通过大学数据练习确定聚类数量,并认识初始中心、异常值和簇形状等局限。主成分分析按五个步骤拆解降维过程,用葡萄酒数据观察信息如何被压缩和保留。自然语言处理部分从文本表示讲到主题建模与潜在狄利克雷分配,可借助论文数据发现隐含主题。图分析则围绕节点、边、中心性、聚类和密度展开,在Facebook关系网络与航空公司航线数据中寻找社群、关键节点和连接结构。
四、掌握智能体通过反馈学习的方法:
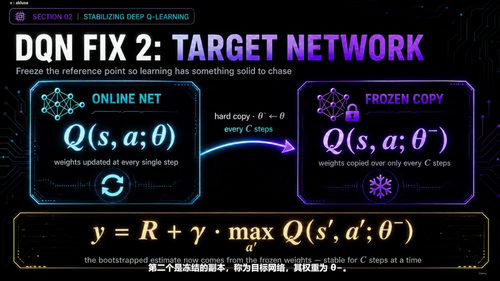
强化学习处理的是另一类问题:智能体在环境里行动,得到的是奖励,而不是逐条标准答案。课程先建立智能体与环境接口、回合式和连续式任务、策略与价值函数、探索与利用等基本框架,再进入表格型方法,讲解蒙特卡洛法、时序差分、SARSA和Q学习,并在冰湖环境中观察不同算法的行为差异。深度强化学习部分会解释规模难题,介绍DQN的经验回放与目标网络,再以平衡杆任务串联策略梯度、演员评论者方法和PPO。最后还会讨论算法选择与实际应用边界,避免把复杂方法当成任何场景的固定答案。
五、让 Claude Code 真正参与学习:
最后一部分不是把智能工具放在课程末尾做装饰,而是教你如何与 Claude Code 结对。配套网站从入门、工具定位、课程导航到三大模块逐项展开,还设置顾问智能体,让你分别获得编程搭档、概念解释、代码审阅和方案讨论。实际使用时,可以让它协助理解报错、生成实验代码、比较模型思路,也可以要求它指出假设漏洞和结果中的反常之处;生成内容仍要结合数据与指标自行验证。这样的训练能减少重复劳动,把更多注意力留给问题定义和判断。
这套课程适合已经掌握基础Python和简单概率统计,希望系统补齐机器学习知识的人;也适合用过几个模型,却常被“该选哪种算法”“指标怎么看”“结果能不能信”困住的初学者。你不必先掌握高等数学,但应愿意亲手运行实验、阅读结果,并对错误结论保持怀疑。学过统计基础的人,会更容易进入偏差方差和估计理论部分。
学完后,你不只是能跟着案例跑出结果,还能说清数据为什么需要某种模型、算法依据什么作出预测、误差来自哪里,以及下一步该换特征、调参数还是换思路。面对新任务时,你会先界定学习范式,再选择合适算法,建立可解释的评估方式,并借助结对编程工具提高实现与复核效率。这样的机器学习能力,核心在于让结论经得起数据检验。