资源介绍
视频数量:8个
总时长:1小时21分
课程介绍:
从查询到看板:网站性能分析与动态告警
线上告警突然变多,值班团队却仍然不知道问题出在哪里。一个结账接口的整体响应时间约为三百三十毫秒,有的支付渠道只有二百二十毫秒,有的却接近四百三十毫秒。平均值看起来还不算糟,真正拖慢业务的分组却被藏了起来。怎样从海量遥测数据中找到这类证据,又怎样把发现变成图表和告警?新课以 New Relic 为工作环境,带你完整走通这条路径。
一、从运营问题写出第一条查询:
课程先从真实问题切入,而不是让你背语法。你会看到一条查询如何从原始事务记录开始,经过范围筛选、指标汇总和结果比较,最终回答“结账请求用了多久”“哪些支付渠道更慢”这样的具体问题。
在查询笔记中,先用 FROM Transaction 选择事务数据,再通过 WHERE 限定应用、结账环节和时间范围。原始结果包含客户层级、交易阶段、请求时长等上下文,但逐条阅读效率很低。接下来,课程会逐步加入计数、平均值、最大值等统计方式,把零散记录整理成能支持判断的指标。
这一部分重点掌握 SELECT、WHERE、SINCE、LIMIT 等常用结构,以及查询范围与聚合层次之间的关系。学完后,你不仅能写出会返回数据的查询,还能清楚知道每一段条件负责筛选什么、每一个统计字段回答什么问题。
二、过滤、分组并发现隐藏趋势:
只看到总体平均值,往往会错过最需要处理的异常情况。课程用支付渠道对比呈现这一点:整体结果只提示结账流程值得关注,FACET 分组后才能定位真正缓慢的渠道。
你会理解 WHERE 与 FACET 的不同作用。WHERE 决定分析哪些数据,FACET 决定按照什么维度比较数据。支付提供商、应用版本、地区、客户类型和交易结果,都可以成为分组角度。课程还会讲解时间序列、桶化趋势和历史对比,让你识别平时少见的延迟上升、错误率波动与阶段性异常,而不是只盯着单个时间点。
三、把分析结论放进服务看板:
查到问题后,如果仍要反复切换页面、重复输入查询,排查效率依然很低。课程会带你设计面向站点可靠性工程的 NRQL 看板,将请求量、响应时间、错误率、渠道差异和关键业务指标放在同一视图里。
你会学习如何根据问题选择折线图、柱状图、分组结果和明细表,设置时间范围、筛选变量、阈值标记与信息层级。看板不是指标越多越好,而是要让值班人员迅速看懂服务是否健康、异常集中在哪里、接下来该查什么。课程也会说明如何保存可复用查询,让同一套分析逻辑持续服务于日常巡检和故障排查。
四、用动态阈值减少无效告警:
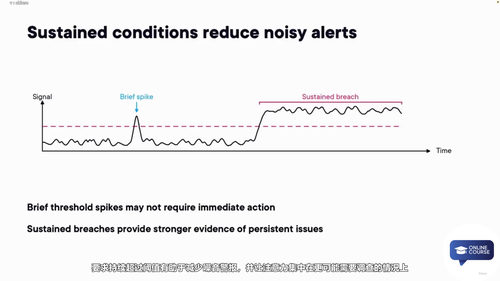
静态阈值很容易制造告警疲劳。业务流量正常上涨时会被误报,流量较低时又可能漏掉异常。课程围绕 NRQL 告警展开,讲清查询条件、持续时间、阈值设置、严重程度、通知路由和恢复规则之间的关系。
你将使用结账错误持续升高这一场景练习配置告警,并结合动态基线,让阈值随历史表现调整。关键业务还可接入工作流,把通知发送给真正负责的团队,并附上定位问题所需的查询和处置信息。这样形成的告警不只是“告诉你有问题”,而是能够说明问题是什么、影响了谁、应该从哪里开始处理。
五、查清文档与告警中的常见陷阱:
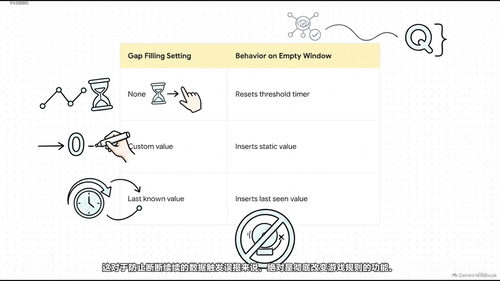
这一部分专门整理实操中容易出错的环节,包括字段名称写错、数据类型不匹配、时间窗口设置不合理、空值处理不当,以及查询本身正确但告警策略配置失当。课程还会介绍 New Relic 文档和 NRQL 参考资料的使用方法,教你自行确认语法与字段含义。
此外,课程进一步梳理告警条件、告警策略、通知渠道和工作流之间的关系。理解这些层次后,你就能判断问题究竟出在查询、数据、阈值,还是通知流程,减少那种查了很久才发现配置方式不对的时间损耗。
六、配套实验把知识连成完整流程:
课程提供查询起步包、语法速查表、检查清单、常见问题手册、行动计划和结课实验,还配有实践工作手册、查询目录及完整演示项目。演示环境包含网页、支付和库存服务,并配有流量生成工具,可反复制造正常访问与异常场景。
八段视频总时长约一小时二十一分钟,节奏紧凑,适合站点可靠性工程师、运维人员、后端开发以及正在接触 New Relic 的可观测性从业者。你可以跟着示例逐步操作,也可以先独立完成实验,再回到对应片段检查思路。学完之后,你将能够从运营问题出发写出生产级 NRQL 查询,用分面和时间序列找到隐藏趋势,制作真正能支持判断的看板,再把同一套数据转化为少而准确的动态告警。