资源介绍
视频数量:28个
总时长:1小时56分
课程介绍:
人工智能治理风险与合规实战指南
一个团队刚把生成式AI客服推上线,几周后客户发现回答里带着偏见,内部数据也被员工贴进了外部工具。老板问,谁批准的?谁检查的?出了事谁负责?这类问题现在越来越常见,而它们正是人工智能治理、风险与合规要回答的。这门课有28个视频,总时长1小时56分,每个视频不长,却把治理结构、负责任AI、合规规则三条线串了起来。它对应SecAI加认证第四领域,这个领域占考试19%,而且大量用情景题来考。课程不要求你背法条,但要求你能在场景里认出该找谁、该用哪条规则、该防哪种风险。
一、谁来决定,谁来交付,谁来检查:
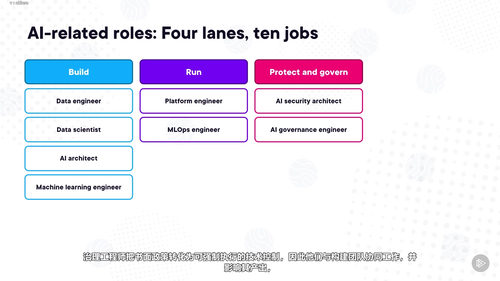
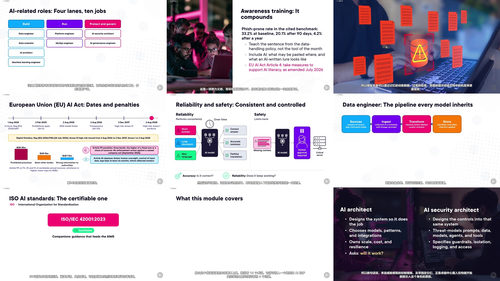
第一个模块讲AI治理结构和角色。开头先把14个术语归到组织必须回答的四个问题里:谁决定、谁交付、谁保证。听起来抽象,但考试和实际工作都吃这一套。比如AI卓越中心放在组织结构中间,它决定一个新AI用例能不能获批。政策是规则,程序是每天怎么执行规则。视频里把这两者分得很清楚,因为很多公司有政策却没程序,员工照旧乱用工具。接着是AI相关角色,课程用4条车道、10个岗位来梳理。数据科学家和数据架构师负责什么,机器学习工程师、平台工程师、MLOps工程师怎么分工,AI架构师和AI安全架构师差在哪,治理、风险、审计角色又怎么配合,数据工程师在数据管道里承担什么责任。最后用治理场景做练习,让你把岗位和结构对上号。学完这部分,你不会再把“AI负责人”当成一个模糊头衔,而是知道每类事情该落到谁头上。
二、负责任AI不是口号,而是风险清单:
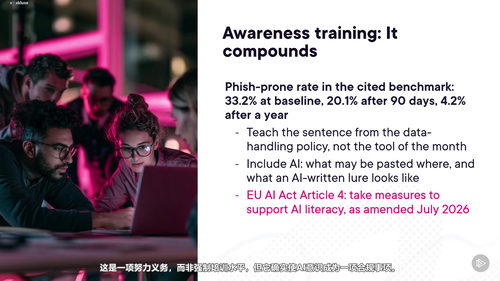
第二个模块有12个视频,专门讲负责任AI和AI风险。很多团队说要做负责任AI,但一被问公平性、可靠性、安全性、透明性、隐私、可解释性、包容性、问责制和一致性,就只剩口号。这门课把这些拆成可检查的条目。比如公平性不只是训练数据均衡,还包括模型上线后不同人群的表现;可靠性关系到模型在真实环境里会不会崩;透明性和隐私涉及用户是否知道数据怎么用;差分隐私讲的是在数据里加噪声保护个体,同时还能训练模型;可解释性让你能向业务和监管说明模型为什么这样判断。课程还讲意识培训,以及承诺在哪些地方会破掉。风险部分很具体:偏见怎么被引入,数据怎么意外泄露,声誉损失怎么发生,模型准确性和性能怎么下滑,知识产权风险在哪里,自主系统可能闯什么祸,还有影子IT和影子AI。影子AI尤其现实,员工自己用外部AI工具,公司根本不知道数据去了哪。最后用场景练习命名风险,对应考试里“这是什么风险”的问法。学完这部分,你手里会有一张风险地图,而不是只知道“AI有风险”。
三、合规规则从哪来,企业该怎么接:
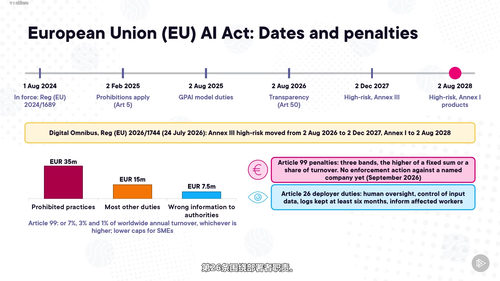
第三个模块讲AI合规和业务要求,8个视频。它先给一个总览:三类规则来源和一个生命周期。三类规则是法律、标准、公司政策。法律里重点讲欧盟AI法案,包括风险分类、实施日期、义务和处罚。标准里讲OECD、ISO 42001和NIST AI RMF,课程会说明它们各自干什么:一个给原则,一个给可认证的标准,一个给自愿性风险框架。很多资料把这三个混在一起,这门课帮你分清谁约束力强,谁来执行。然后落到企业内部:公司政策决定员工能用哪些AI系统,能把什么数据放进模型,模型是批准、私有还是公开。视频还讲私有模型和公共模型的区别,敏感数据治理,第三方合规,数据主权。数据主权对跨国企业特别重要,因为数据放在哪个国家,可能直接决定合规不合规。最后用场景走查和考试区分做收束。考试目标用了“总结”这个词,所以你不用成为律师,但必须识别合规要求的主要来源,理解它们给构建和使用AI的组织带来了什么变化。
四、这门课适合谁:
如果你正在备考SecAI加认证,尤其是第四领域总丢分,这门课值得看。它把情景题常考的结构、角色、风险名称、规则来源一个个拆开。如果你是安全经理、合规专员、法务、审计人员,正在被公司问“AI能不能用、怎么用、谁负责”,课程里的治理结构、政策程序、影子AI、第三方合规都能直接拿去开会。如果你是数据科学家、机器学习工程师、MLOps工程师或AI架构师,你会更清楚自己做的事在治理链条里的位置,也知道怎么和风险、审计团队对话。如果你是企业IT管理者,需要批准AI工具、制定使用规范,课程里关于批准与未批准工具、私有与公共模型、敏感数据治理的内容能帮你少踩坑。甚至如果你只是团队里那个被拉去管AI的人,这套短课也能让你快速建立框架。
整门课28个视频,不到两小时,信息密度不低。它不会把你变成律师,也不会教你写模型代码,但它会给你三样东西:一张角色分工图,一份风险清单,一套合规规则地图。下次再遇到AI出事,你不会只问“模型怎么这样”,而会先问谁批准的、数据从哪来、违反哪条规则、该找哪个角色处理。这就是治理、风险与合规的价值。