资源介绍
视频数量:38个
总时长:2小时11分
课程介绍:
人工智能编程实战:提问、测试与验证
凌晨两点,值班电话响了。上游服务超时后把同一个事件重发了一次,你的系统却生成了两张客户工单。你打开编辑器,把报错和那段代码一起丢给助手,几秒钟后它给出一个补丁,测试全绿。你合并、上线、睡觉。第二天早上,数据库里躺着一排重复工单。
从让机器帮你写,到敢为结果负责,中间隔着一段不长、但特别容易被跳过的路。这门课用一套叫 RelayDesk 的小型工单服务,把这段路一格一格走一遍。38 个视频,2 小时 11 分,从复现一个缺陷开始,到交出一份带证据的变更结束。每一章都配好了可以直接上手的三份代码:起始版本、参考版本,还有一个故意做错的候选版本。
一、先学会不信:调试 AI 给出的修复
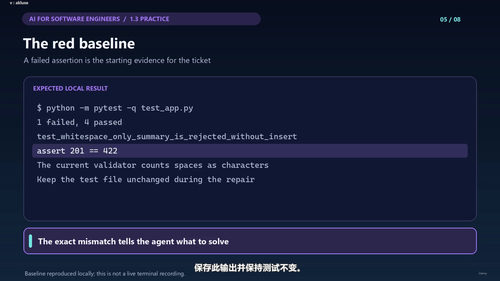
第一章讲的不是怎么写代码,而是怎么怀疑一个看起来正确的补丁。你先看清这套系统的结构:一个接收事件的接口,把事件编号、客户编号和摘要写进数据库,返回新工单号。缺的是什么?没有任何规则规定同一个事件编号只能出现一次。重试测试因此失败,而失败本身是有用的证据,不是要赶紧藏起来的麻烦。
接下来,你把确切的失败复现交给智能体,让它去改,然后自己动手检查它到底改了什么。课程里专门展示了一个测试全绿、行为却仍然错的补丁,你会用一条数据库探针去挑战一个已经通过的测试。三个练习分别对应:复现重试问题并核对数据库的唯一性约束、用探针挑战通过状态的测试、用先计划再打补丁最后跑测试的方式修一个校验缺陷。
二、把模糊的需求变成能测的提示词
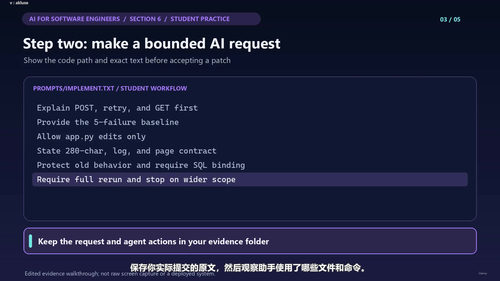
第二章处理一个更日常的麻烦:手上只有一张含糊的工单。你会学到怎么把它改写成一条能被验证的提示词,怎么在让智能体动手之前先索要仓库里的证据,怎么只请求一个单文件补丁并验证它的实际行为。还有一个很实用的手法:当它给出没有依据的结论时,别跟它争,也别把问题原样再问一遍,而是把那条错误主张连同代码里的反例一起发回去。课程完整演示了它怎么撤回一处凭空的架构建议,以及为什么第一次纠正仍然不到位。
三、少给上下文,多留证据
第三章讲节省。你要读懂令牌用量,但别把它直接等同于花费;只把真正相关的仓库片段喂给模型,而不是把整个项目塞进去;写一份状态笔记,让中断的会话第二天还能接着往下做。练习是搭一个上下文包、量一次真实用量、留下一份可复用的状态记录。这一章的价值在长会话里体现得最明显,上下文越干净,模型给出的判断越稳。
四、按任务风险挑模型
排行榜每天都在变,光看名次没用。第四章教你读编程基准以及它的局限,用同一把事先定好的尺子给两个模型的答案打分,再根据任务风险和手上已有的证据决定用哪一个。风险高的任务用更强的模型加人工复核,风险低的就交给便宜模型跑量,这张分派表能把选择从感觉变成规则。
五、给智能体划好边界做功能
第五章开始真正做一个功能。把功能工单拆成可验收的用例,给智能体划清它能碰的范围,看它实现并测试一个小功能,然后审查补丁,在必要时拦下一次不安全的发布。你练习的是计划、实现、测试、复审一个优先级过滤功能。
六、测试、探测、复审
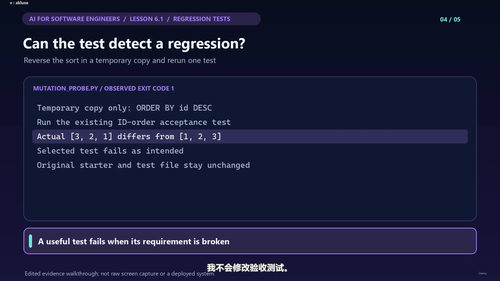
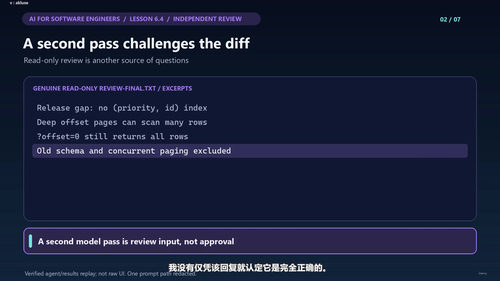
第六章把验证做得更硬:写能暴露回归的测试,顺着数据流查出并堵住一处隐私泄露,用三千行数据探一探分页和重试的边界,再请一次只读复审去找隐藏的边界问题。第二双眼睛很关键,同一个模型换成一个只读的视角,常常能发现它自己写测试时看不见的缝。最后自己动手测试补丁、探测边界、判断这个版本能不能发布。
七、事故诊断与发布决策
第七章面向线上。从日志和数据库证据里诊断一次重试事故,修好旧数据库上的失败但不把测试藏起来,在干净环境里把运维手册完整演练一遍,再根据证据做出发布或者暂缓的决定。这一章练的不是写代码,是在压力下给出能追溯的判断。
八、结课项目:交出一份有证据的变更
最后几课不再给答案。你要自己定义一个变更契约和一条注定失败的基线,用有边界的智能体把它实现出来,然后主动挑战那个已经变绿的补丁,写出一份别人能直接接手的交接说明。做完这一步,你会拥有一套完整的、从提示到验证的闭环。
这门课适合谁?每天都用人工智能写代码,却每次合并前心里都没底的工程师;要替团队定下什么补丁可以进主干这类规矩的技术负责人;还有负责发布把关、常常要在半夜做决定的值班同学。学完之后,你拿到的不是又一个炫技的工具,而是一套能重复执行的流程:从复现失败开始,到留下证据结束。