资源介绍
视频数量:11个
总时长:46分
课程介绍:
用Python搭建电商自动化产品引擎
一个做电商的朋友曾经给我看过他的工作流程:打开一个装满产品信息的Excel表格,手动复制标题到亚马逊后台,再切换到Shopify粘贴一遍,然后打开eBay又粘贴一遍。价格要逐个平台算,因为每个平台的佣金和费用结构不一样。有次他把一个成本是零的产品挂了上去,卖出去一单才发现亏了钱。更别提那些缺失尺寸、条形码错误的商品,被平台下架了好几次。他问我,这些东西能不能自动化?
这就是这门课要解决的问题。它教你用Python搭建一套完整的电商产品自动化引擎,从混乱的源数据开始,经过清洗、定价、验证、AI增强,最终把商品发布到亚马逊、eBay和Shopify三个平台。学完之后,你手里会有一套真正能跑的代码,不是Demo,不是玩具。
课程一共11个视频,46分钟,紧凑但不省略细节。下面按模块说说每个部分在做什么。
一、自动化基础与项目搭建:
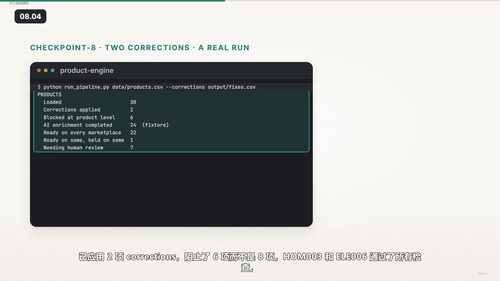
第一个模块先把整个系统的骨架立起来。你会先看到完整的成品运行效果——26个产品准备就绪,1个产品只能在部分平台销售,4个商品被暂缓刊登。这个全局视角很重要,因为后面的每个模块都在往里填内容。然后从项目结构开始搭建,config目录放平台费用规则和品类规则,data目录放源数据,engine目录放核心逻辑,tests目录做测试。最后你会跑通第一条完整的Pipeline:读入产品数据,经过基本处理,输出结果。这条管道很粗糙,但它是后面所有功能的载体。
二、数据清洗与标准化:
真实世界的产品数据有多脏,做过电商的人都知道。同一个字段,有人写“红色”,有人写“Red”,有人写“RED”,还有人写“红”。尺寸格式不统一,单位混杂,空白字符到处都是。这个模块教你写normalize模块,把这些问题数据统一成规范格式。同时还会做源数据的早期拦截——比如成本为零的产品,在任何平台都是错误的,没必要等到发布阶段才发现。这一层拦截放在数据处理的最前面,能省掉很多后续的麻烦。
三、定价与利润引擎:
这是整个系统里最有意思的部分之一。课程里举了一个卷尺的例子:TLS-002这个产品,在Shopify和Amazon上都能赚到利润,但在eBay上不行,因为eBay上买家愿意支付14.99美元,而底价是15.06美元。如果简单地把整个产品标记为“不可售”,就会白白丢掉两个能赚钱的平台。所以系统引入了刊登级别的定价判断:每个产品在每个平台上都有一个独立的刊登条目,价格不达标只暂缓那个平台的刊登,不影响其他平台。config/fees.json里配置各平台的费用规则,pricing模块计算每个平台的实际利润空间。这里的核心思路是区分商品级问题和刊登级问题,商品级问题在所有平台都拦截,刊登级问题只影响特定平台。
四、GTIN验证、品类与属性校验:
产品要发布到平台,必须符合平台的规则。亚马逊要求GTIN(全球贸易项目代码),品类要和产品匹配,必填属性不能缺失。这个模块教你写gtin模块做校验位验证,用category_rules.json定义品类规则,validation模块检查属性和品类的一致性。这里有一个重要的设计原则:规则会应用到每一个产品,即使这个产品已经被拦截了。为什么?因为如果审核员修复了一个问题,重新运行后才发现第二个问题,就白白浪费了一次审核往返。所以一次性把所有问题都暴露出来,让审核员一次修完。
五、AI增强与安全护栏:
这个模块加入AI能力,用来补全产品信息、生成描述、推断缺失属性。但AI的输出不能直接信任,所以课程设计了一层“护栏”——先用规则约束AI的输出范围,再主动攻击这层护栏,看它在什么情况下会失效。fixtures/ai_overrides.json提供了可控的测试场景,确保AI增强部分在异常情况下也不会产生错误结果。这个模块的讲解方式很务实:先建防线,再试着突破它,确保防线真的管用。
六、多平台映射与发布载荷:
同一个产品,发布到亚马逊、eBay和Shopify,需要的数据格式完全不同。这个模块教你写marketplaces目录下的代码,为每个平台实现独立的映射逻辑。amazon.py负责亚马逊的字段映射和载荷组装,ebay.py和shopify.py做同样的事情,但它们都继承自base.py定义的统一接口。这样设计的好处是,上层的Pipeline不用关心具体平台的差异,只需要调用统一的接口。课程会以亚马逊的映射为例,详细演示从产品数据到发布载荷的转换过程。
七、OAuth、API与安全发布:
发布到平台需要认证。这个模块讲OAuth授权流程,以及如何安全地管理API凭证。env.example文件里定义了需要的环境变量,publish模块负责处理发布逻辑。重点在于安全:凭证不能硬编码在代码里,API调用要有错误处理和超时机制,发布操作要有幂等性保证,避免重复发布。
八、错误处理、重试与人工审核:
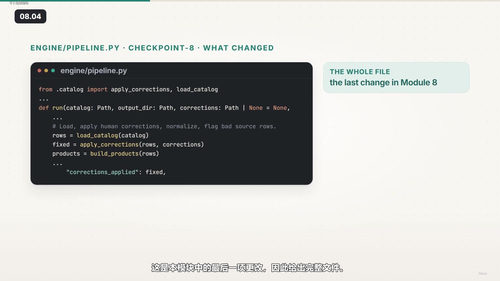
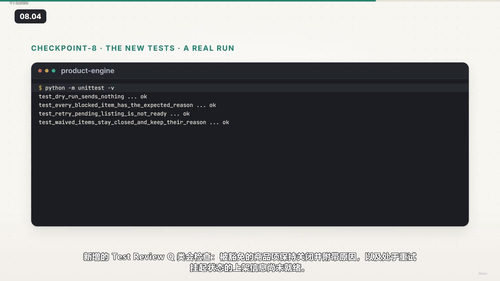
自动化系统一定会遇到错误。API可能超时,数据可能突然不符合格式,平台的规则可能变化。这个模块教你设计重试机制和人工审核队列。review_queue模块管理需要人工介入的商品,corrections.example.csv展示了如何批量修正问题然后重新处理。课程里有一句话说得很好:审核员应该能看到所有问题,而不是修完一个又冒出来一个。这个模块的目标就是让错误处理流程化、可追溯、可批量操作。
九、完整运行与综合演练:
最后一个模块把前面所有部分串起来,跑一次完整的Pipeline。从源数据读取开始,经过清洗、定价、验证、AI增强、平台映射、发布,最后清空审核队列。25号课程演示的是亚马逊映射和载荷阶段的全流程,38号课程是综合演练,手动清空审核队列。到这里,你会看到一个完整的、可运行的产品引擎,它每天可以处理成百上千的商品,自动完成那些你曾经手动复制粘贴的工作。
适合学这门课的人,是那些已经在做电商运营、或者准备做电商自动化工具的人。你可能已经在用Excel管理产品,或者用一些现成的工具但觉得不够灵活。你需要会基本的Python语法,知道怎么读写文件、怎么安装依赖包。不需要你是Python高手,但至少要能看懂函数和类。如果你曾经被跨平台发布和数据清洗折磨过,这门课会很对你的胃口。
学完这门课,你得到的不是一段演示代码,而是一个结构清晰、有测试覆盖、能处理真实问题的产品引擎。你可以直接拿它处理自己的商品数据,也可以把它作为一个基础框架,加入自己需要的平台或功能。46分钟的视频,你会看到每一行关键代码是怎么写出来的、为什么这么写。