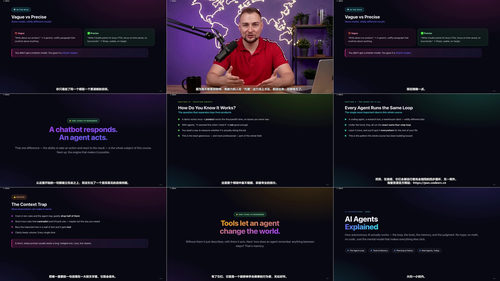
资源介绍
视频数量:56个
总时长:1小时2分
课程介绍:
AI智能体入门:把"智能体"这个词彻底讲明白
开会的时候有人冒出一句,我们给这块业务上个智能体吧,一屋子人点头,散会之后却没人能说清智能体到底指什么。更常见的版本是,手机里那个语音助手到底算不算智能体。问题看着简单,卡住的聪明人却不少。这门课就是冲着这件事来的,一共56节短课,每节一两分钟,净时长只有一个小时出头,讲的全是实打实的概念,没有绕圈子的铺垫。
一、先把被混着用的几个词拆开:
课程一开始直接拿语音助手开刀,问它算不算智能体,然后摆出三张牌:聊天机器人、自动化流程、智能体。三者听起来差不多,做事的方式却完全不同。一个只会回话,一个照着预设规则跑,只有第三个会根据结果自己决定下一步。分清这三者,后面所有内容才有落脚点。同一部分还有一节专讲流传最广的那个误解,听完你大概会松口气:它没那么神,也没那么玄。此外还有暖场和讲师自我介绍,讲师坦白说这门课的幻灯片和配音确实用了AI工具,但讲稿、例子、观点全部出自他本人。一门讲智能体的课自己拿智能体做出来,这个选择本身就很说明问题。
二、看一眼引擎盖下面那台机器:
第二部分讲大语言模型。这里有个很好用的比喻:它不是搜索引擎,更像一个读完了整个互联网的即兴演员。你抛一句台词,它立刻给出最顺的下一句,流利、自信、从不卡壳。代价是,它宁愿编得顺畅,也不愿承认自己不知道。这一段会解释词元、下一个词元预测、上下文窗口这三件事,一个公式都不涉及。理解这三点,你会突然明白为什么同一个问题问两遍会得到两个答案,那是采样,不是故障,也是它既聪明又不可靠的根源。
三、循环、工具和记忆:
从第三部分开始进入骨架。所有智能体其实都在跑同一个循环:感知、推理、行动、观察,然后回到起点,这里会用一段完整的演示让你看清循环怎么转。接着是工具,也就是给智能体装上"手",让它能调用搜索、数据库、计算器,它才真的能做事。但每一次调用都是风险敞口,这部分会讲清危险藏在哪。再往后是记忆,课程叫它"金鱼困境":短期记忆和长期记忆怎么分工,为什么上下文塞得越满效果反而越差。
四、会翻车,才需要有人盯着:
第七部分列出智能体最常见的五种翻车方式,从跑偏目标到陷入死循环,逐一演示,再讲怎么把控制权留在自己手里。看完这一段,你不会再迷信"全自动"这三个字。
五、提示词、上下文和你自己的数据:
第九部分讲怎么跟智能体对话:系统提示、任务描述、示例三者怎么配比,少样本示例为什么有时反而帮倒忙,还有一个值得记下来的概念叫上下文工程。第十部分解决另一个现实问题:模型根本不知道你公司的内部资料。检索增强生成怎么补上这一块,向量嵌入这个环节为什么最容易出问题,以及它和微调该怎么选,都讲得很直接。
六、真实世界的用法和设计模式:
第八部分先把科幻放一边,看今天真正在干活的智能体长什么样,它们身上有什么共同规律。第十一部分给出几个现成的设计模式,包括推理与反思、规划者与执行者、编排者模式,最后一节叫"保持简单",讲的是什么时候不该用复杂架构。第十二部分聊多智能体:什么时候一个不够用,一队智能体怎么协调,智能体之间怎么对话,还有一句很实在的提醒,复杂度是要靠本事挣来的,不是默认配置。
七、接上外部世界,并且证明它靠谱:
第十三部分讲智能体如何通过接口和标准协议连上外部系统,工具需要插座,标准接口解决的就是这件事,随之而来的安全与规范问题也一并讲清。第十四部分回答那个最容易被跳过去的问题:你怎么知道它真的在工作。评测、追踪、护栏是三个抓手,用大模型当裁判的做法有什么局限,以及为什么关键环节必须留一个人在回路里。
最后一节把整套心智模型重新串一遍,附上检查清单和继续学习的方向。一个小时学完,你能拿着这些概念跟同事把智能体讲清楚,能判断一个需求该不该交给智能体做,也能在动手前避开最常见的几个坑。