资源介绍
视频数量:14个
总时长:1小时26分
课程介绍:
端到端机器学习实战:从业务问题到生产上线
想象周一早上,业务负责人把一份客户账户表丢给你,说流失有点严重,能不能用机器学习提前找出可能走掉的客户。你打开文件,三十列,有些列名看得懂,有些看不懂,数据字典只有薄薄几页。真正难的地方立刻出现了:预测谁,提前多久预测,把谁判成高风险,误判的代价各是多少。这门课就从这种不完美的真实场景切入。全课14个视频,总时长1小时26分,时间不长,但把从业务问题到生产监控的整条链路压缩成一条能跟着走的路线。每个环节都配知识检查和动手实验,不是听完就结束。
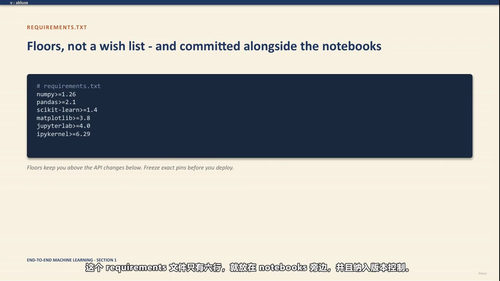
一、先建立全局视角:课程开头不急着调模型,而是用一张图讲清机器学习生命周期,再解释为什么大量模型停在实验环境里进不了生产。你会配置 Python、Jupyter 和常用建模库,认识贯穿全课的数据集。这个部分看似基础,实际是在矫正一个常见毛病:拿到数据就写代码。先知道流程里每一站要交付什么,后面才不会把时间花在无效调参上。
二、业务理解:这一章围绕客户流失问题展开。课程会教你把模糊的业务诉求变成可检验的预测任务,识别哪些问题适合机器学习,哪些问题其实用规则或报表更划算。目标变量怎么定,成功标准怎么在建模前说清楚,都有具体示范。流失定义是三十天不登录还是取消订阅,口径不同,模型和行动方案都会变。学完这一章,你拿到需求不会马上问用哪个算法,而是先问预测发生在什么时间点、模型输出要触发什么动作、业务能承受多少误报。
三、数据理解:数据放在哪里、怎么集中管理、六项质量检查能抓住大多数问题,这些内容会先讲清楚。泄漏单独成节,因为很多看起来漂亮的分数,来源是把未来信息带进了特征。动手部分很有画面感:面对一个从未见过的文件,按固定顺序跑五条检查,先看行列规模,再看字段类型,再看前几行、描述统计和空值计数。字幕里提到任职月数被读成文本,行数还和业务说的客户数差了两百多。课程反复强调,在形成判断前把检查跑完,避免看了前十行就过早自信。接着做端到端探索分析,交付物是一份假设清单,而不是四十张没人读的图。
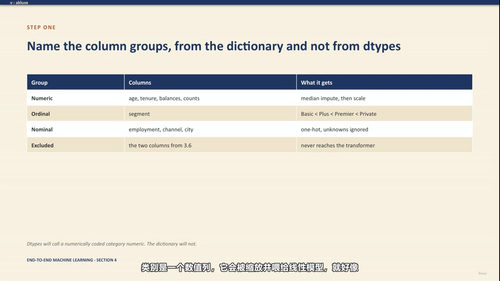
四、数据准备:缺失值不是简单填个均值就完事,课程会区分缺失机制,比较不同插补方法的效果。类别变量怎么编码,缩放什么时候真的重要,类别不平衡时重采样和类权重各有什么代价,都会讲到。动手环节搭预处理流水线,把插补、编码、缩放串成可复用的步骤。这个部分的价值在于防止数据泄漏进交叉验证,也防止训练和上线时的处理方式不一致。很多模型线下好线上差,问题就出在这里。
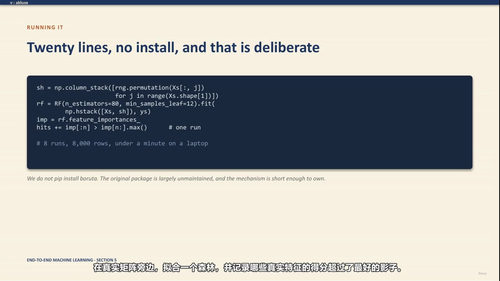
五、特征工程:课程会讲时间、文本和类别字段怎么变成有用特征,特征选择里的过滤式、包裹式和嵌入式方法分别适合什么场景,团队什么时候会需要特征商店。动手部分不是堆特征数量,而是工程能推动评估指标的特征,再用 Boruta 和递归消除做筛选。学完你会有一个判断:特征工程的目标是让模型更容易学到信号,不是把表格撑得越宽越好。
六、建模:从第一个分类模型和回归模型开始,先把交叉验证做对,再谈超参数调优。课程专门提醒调参时不要骗自己,验证集反复使用会带来乐观偏差。集成方法部分讲袋装、提升和堆叠的基本思路。动手环节先建立基线,再上复杂模型,最后用网格搜索和随机搜索调参。这个顺序很重要,没有基线,你无法判断复杂模型多出来的分数是不是值得。
七、评估:指标要匹配决策。精确率、召回率以及每一类错误对应的成本,需要放在一起看。概率校准会解释为什么模型输出的零点八不一定是百分之八十。向业务受众解释模型也有方法。动手部分在真实成本曲线上选阈值,再用 SHAP 解释单条预测。学完这一章,你能把模型结果翻译成业务语言,而不是只报一个准确率。
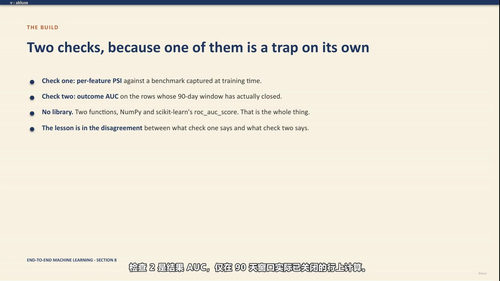
八、进入生产:部署模式包括批处理、在线、流式和边缘,交接给工程团队时需要提供什么,模型服务的负载和性能怎么测,监控里的数据漂移怎么看,重训练策略由谁在什么条件下决定,这些都会涉及。动手做一个能实际运行的漂移检测器。最后综合项目在一个新数据集上把全流程走一遍,课程提供了模板、基准结果和监控脚本,方便你对照自己的做法。
适合人群:已经会用 Python 做基础数据分析,但没完整走过一个机器学习项目的人;学过模型训练,却说不清怎么上线和监控的初学者;需要把业务问题翻译成模型任务的产品经理和业务分析师;以及要和数据科学家对接的工程师。完全没写过代码的人会吃力,因为实验需要跟着改脚本。
学完这门课,收获不是多背一个算法,而是拿到一个新数据集时知道先问什么、先查什么、基线怎么设、评估怎么做、上线后盯什么。14个视频、1小时26分,信息密度不低,很多细节要靠动手实验消化。把它当成一张项目路线图,遇到下一个业务问题时,你会更清楚自己正走在哪一步。