资源介绍
视频数量:21个
总时长:2小时27分
课程介绍:
从大语言模型到提示词:生成式人工智能基础课
你有没有过这样的体验:打开一个聊天窗口,敲下一句“帮我总结这份报告”,几秒钟后屏幕上出现一段像模像样的文字。你明知道背后是模型算出来的,却还是忍不住想问:它到底怎么做到的?这门课讲的就是这个问题。它不要求你先啃完深度学习教材,而是用二十一个短小的视频,把生成式人工智能、大语言模型、提示词和变换器架构这几件事串成一条能听懂的线。总时长两小时二十七分,节奏偏快,但每个概念都落在具体例子上,不是只报名词。
一、先看生成式人工智能到底新在哪里:
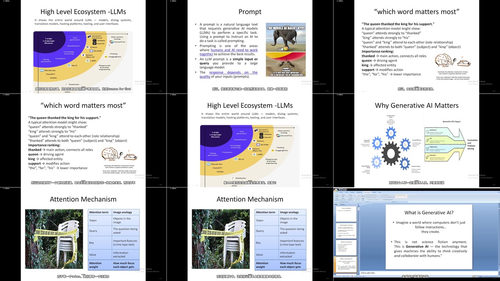
课程开头没有直接扔公式,而是先区分生成式人工智能和传统人工智能。传统人工智能更像做判断题,给一张图判断是猫还是狗,给一条评论判断正面还是负面;生成式人工智能则是在人的指令下写出新内容,邮件、摘要、代码、图片都算。这个区别听起来简单,却决定了后面很多问题的看法。接着课程会讲生成式人工智能的演进脉络,为什么它在这几年突然变得重要,以及背后那批模型和方法的推进。你还会听到它和传统人工智能在训练方式、输出形式、使用方式上的差别。这部分不长,但能帮你建立一张地图,后面听到大语言模型、提示词、注意力机制时,不至于散成一地零件。
二、大语言模型不是越大越神秘:
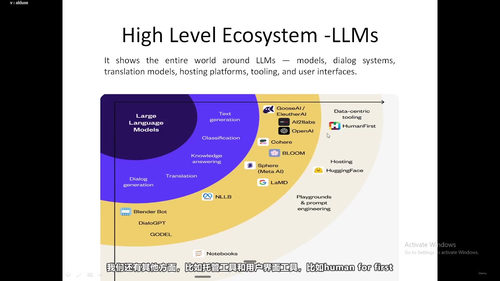
第二部分围绕大语言模型展开。课程会先说明大语言模型到底是什么,它和普通语言模型的关系,以及围绕它形成的工具链:模型、接口、应用、数据。然后专门讲它的局限和挑战。很多人第一次用大语言模型,会被流畅的回答震住,接着又会被它一本正经的胡说八道气到。课程没有回避这一点,而是把限制摆出来,让你知道哪些任务适合交给它,哪些任务需要人盯着。比如事实核查、长文推理、对最新信息的掌握,这些边界在动手之前就该心里有数。学完这一块,你再看各种模型宣传,会更容易判断哪些是能力,哪些是包装。
三、变换器和注意力机制:把黑箱拆开看:
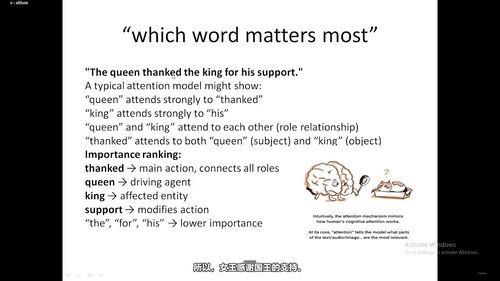
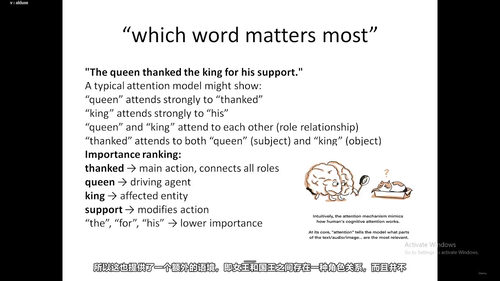
课程中段进入变换器架构。先讲它为什么是一次突破,再讲它的解剖结构。真正占篇幅的是注意力机制。课程用句子和图像两种输入来解释:一句话里哪些词更重要,一张图里哪个区域更关键,模型怎么给不同部分分配权重。你会接触到查询、键、值这些术语,也会看到注意力权重如何影响理解。这里不是让你手推矩阵,而是让你明白“注意力”三个字在模型里到底指什么。视频里还举了家庭照片和犯罪现场图片的例子,说明同一个词在不同上下文里含义会变,模型需要抓的是关系,不是孤立词。听完这部分,你再看到“注意力就是你所需要的一切”这种说法,至少知道它在说什么。
四、词元与嵌入:模型眼里的文字长什么样:
接下来课程讲词元和嵌入。词元是模型处理文本的基本单位,看起来只是切分方式,实际上会影响模型能看多长、算多贵、对罕见词怎么处理。课程会说明词元大小带来的差别,以及为什么同样一段话,不同模型消耗的资源不一样。嵌入则是把词元变成向量,让语义关系可以在空间里比较。课程用语义空间的类比来解释“国王”“王后”“男人”“女人”这类关系,也会讨论什么样的嵌入算好嵌入。这部分对理解检索、聚类、推荐都有帮助,不是只服务于聊天机器人。
五、提示词不是咒语,是把要求说清楚:
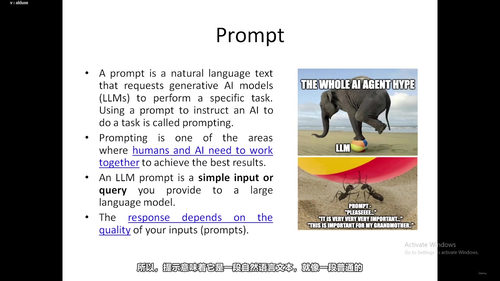
提示词部分很实用。课程先讲该给模型什么信息、该期待什么输出,再给具体例子。它不会把提示词说成玄学,而是强调结构:任务是什么,背景有哪些,输出格式怎么定,哪些约束不能丢。例子覆盖了常见写法,也展示了提示词改一个字、换一个顺序,结果可能差很多。学完这部分,你写提示词会更像写一份清楚的工作说明,而不是往窗口里扔几个关键词。
六、动手实验:在Colab里接上Hugging Face:
课程最后三个实验把前面概念落到手上。先配置Colab和Python环境,再认识Hugging Face,比较用流水线调用和手动加载模型的差别,最后尝试开源模型。实验不算长,但能让你看到模型怎么被调用、输入怎么变成输出、不同加载方式对使用有什么影响。对没接过模型接口的人来说,这一步很关键,它把“大语言模型”从新闻里的词变成能跑起来的东西。
这门课适合谁?写文案、做运营的人,可以弄明白平时用的工具背后发生了什么;产品经理能借此判断模型能力边界,少提不切实际的需求;刚接触机器学习的学生可以把零散名词串起来;后端开发者想接模型接口,也能从Hugging Face实验里找到手感;数据分析师如果开始用嵌入做检索或聚类,前面几节会有直接帮助。它不替代系统的深度学习课程,也不承诺两小时成为专家,但它能把生成式人工智能、大语言模型、变换器、词元、嵌入和提示词这些常听到的词讲清楚,让你在讨论、选型、写提示词和跑小实验时更有底。