资源介绍
视频数量:45个
总时长:3小时56分
课程介绍:
Jev决策AI入门实战
一家公司每天要处理上万条客服消息。判断是不是退款申请、标记垃圾邮件、决定工单优先顺序,这些问题看起来只差一个答案,但如果每次都调用大型聊天模型,不仅速度慢、成本高,返回格式还可能突然出错,让程序当场崩溃。问题不在于模型不够聪明,而在于用错了工具。本课程围绕Jev这类决策模型展开,带你从判断需求、调用方法到模型评测,完整走通一条决策AI实践路径。
一、认识决策AI:
课程先从一个常见的场景切入:软件每天都在替人做决定,只是这些决定不像写文章那样引人注目。邮件系统判断垃圾邮件,支付系统评估风险,客服系统识别退款意图,智能体选择下一步工具,这些任务都属于决策AI的范畴。
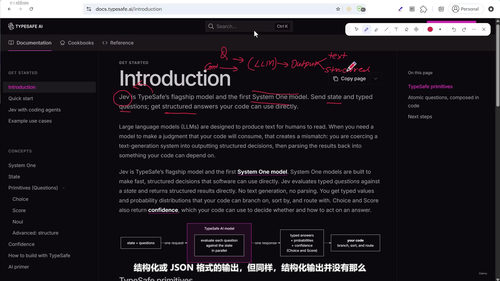
你会了解Jev与LLM的定位差异。LLM适合展开讨论、撰写内容、总结材料,决策模型则针对答案有限、需要快速返回结果的任务工作。它接收输入和问题,再按照代码可预期的格式给出答案、概率与置信度。这样的设计让模型更适合嵌入业务流程,而不是只停留在聊天窗口里。
课程还会回顾Jev出现之前,软件常用的3种决策方式,并把Jev的创建背景与设计动机讲清楚。通过“快速思考和慢思考”以及“系统一模型”的概念,你会理解为什么有些判断追求极致速度,有些任务则需要更多推理与解释。
二、拆解一次决策调用:
一次决策调用究竟包含哪些信息,是理解后续内容的基础。你将认识状态、问题、输入、答案和置信度分别承担什么角色,并学会区分3类核心问题:选择、评分和拒答,也就是目录中的Choice、Score和Noul。
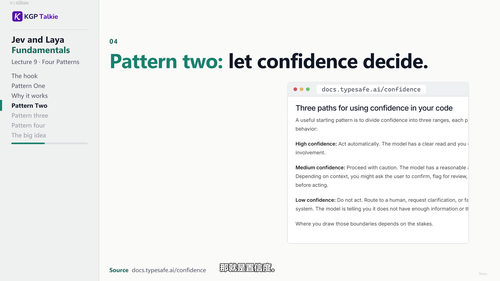
选择类问题适合明确分类,例如判断天空颜色、选择处理某类请求的团队;评分类问题适合评价程度,例如评估内容得分、风险高低或需求紧迫性;拒答类问题则允许模型在证据不足时明确表示无法判断,避免为了给出答案而勉强猜测。
这一部分还会深入概率、置信度与校准之间的关系。你会发现,输出一个看似精确的数字并不等于模型真的可靠,而置信度是否合理,需要结合任务类型和实际结果来判断。
三、掌握Jev的训练与决策模式:
课程会介绍RLHF、RLVR和RLCD等训练思路,并进一步分析系统一的快速决策机制。训练方式决定了模型如何形成偏好、如何根据可验证结果调整,以及怎样在特定标准下学习更稳定的决策行为。
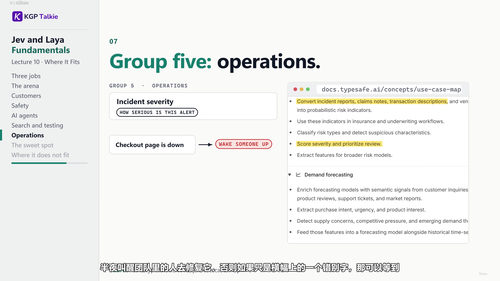
随后,你会接触团队每天都在使用的4类决策模式,并把它们放进更广泛的业务场景中。课程还整理了10个典型用例,包括客服工单分流、评论洞察、潜客资格判断、提示注入防护、个人数据检查、支付风险评估、智能体工具路由、RAG段落过滤,以及搜索与测试场景。
每个用例都对应一个清楚的问题:系统要判断什么,需要怎样的输出,又为什么不该使用聊天模型。这样一来,原本零散的功能需求就能被整理成可实施、可测试的决策任务。
四、比较聊天接口与决策接口:
Chat Endpoints和Decision Endpoints看起来都来自AI服务,使用方式却完全不同。课程会对照两者的请求方式、返回结构、延迟、成本和适用边界,帮助你在项目选型时做出更准确的判断。
你还会认识当前决策模型的类型,以及支撑它们运行的工具。课程特别分析了Jev的不足,让学习者既看到它的优势,也了解它在哪些场景仍需要传统规则、其他模型或人工复核配合。这样的视角比单纯展示功能更有价值,因为真正的应用很少只靠一个组件完成。
五、进入TypeSafe AI操作台:
完成概念学习后,课程带你进入TypeSafe AI,注册账号并熟悉Jev AI Playground的操作界面。你会看到如何提交状态和问题,如何阅读返回结果,以及怎样根据模型反馈不断调整输入。
课程安排了几个循序渐进的实操案例。热狗案例用于理解拒答机制,天空颜色案例展示选择型问题,Naruto版权案例则分两部分演示评分模型。案例不会停在“看懂演示”,而是把问题写法、判断依据和结果解读连在一起,让你可以照着同样的步骤完成自己的任务。
六、深入理解状态与问题原语:
这一部分从TypeSafe AI文档入手,进一步解释Jev的运行方式。状态代表模型作出判断时所依据的情境,问题则是模型需要处理的基本单元。理解这两层结构后,你就能把复杂业务要求拆成更清晰的决策问题。
你会依次学习结构化指令和判断标准、选择原语、评分原语与拒答原语,并观察Jev AI请求和响应的完整结构。课程还总结了提高输出质量的方法,包括怎样描述背景、怎样限定可选范围、怎样制定可比较的评分等级,以及怎样避免含糊指令。
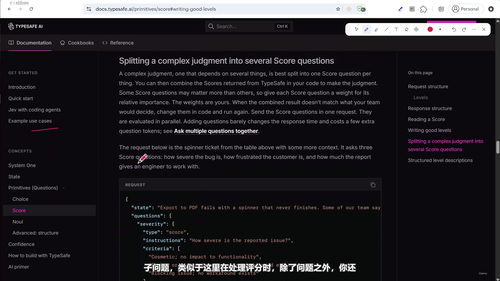
评分模型尤其需要细致的设置。课程会讲解评分的计算方式、示例拆解和等级编写原则,并分别说明评分与选择任务中的置信度产生方式。直观动画还能帮助你看到置信度如何随判断变化,从而对模型的不确定性建立更清晰的认识。
七、评测并比较决策模型:
最后进入System One Arena。这里可以并排比较Jev、聊天模型以及其他决策模型,帮助你从单一演示走向有依据的模型选型。你会熟悉评测面板,查看不同模型在同一任务上的判断、得分和置信度表现。
课程还讲解OpenRouter统一接口的用法,包括创建API密钥、发起第一次决策AI API调用。Clef和Tev1等基于LLM构建的决策模型也会被纳入对照,Jev、Clef与GPT-6 Luna之间的直接测试,让你直观看到不同模型在速度、准确性和稳定性上的差异。
最后,10类实际用例构成一次完整的基准测试。你不再只凭宣传信息或单次体验做决定,而是可以根据业务任务筛选模型,形成自己的评测标准。
八、后续扩展方向:
课程还预留了Jev API、Jev工作原理、本地运行、文字转结构化数据以及使用自有数据测试等扩展模块。部分内容目前标记为后续发布,但整体学习路径已经清楚呈现。Ollama相关内容和不同供应商提供的Jev式接口,也为本地部署与统一调用留下了入口。
这套课程适合产品经理、开发者、AI应用工程师和技术负责人,尤其适合正在处理客服分流、内容审核、风险判断、智能体工具选择或RAG过滤任务的人。如果你想理解决策模型与聊天模型的边界,或者已经使用LLM,却常遇到响应慢、费用高、结构不稳定和结果难以评测的问题,这段学习会让你建立一套更扎实的决策AI方法。