资源介绍
视频数量:14个
总时长:1小时26分
课程介绍:
机器学习模型工程化实战
模型训练完成,并不等于它已经准备好投入业务。一个模型可能在笔记本上表现很好,代码也交给了同事,可当数据发生变化、团队多人同时修改、服务流量突然增加时,问题便接踵而至:这次运行的参数和指标存在哪里,旧模型如何回退,新模型能否自动上线,上线后又该怎样发现性能下降。MLOps要解决的,正是从实验成功走向生产稳定之间的这段距离。
这门课程以MLflow为核心工具,同时覆盖持续集成与持续交付、特征存储、模型监控以及规模化运营。课程包含14个视频,总时长1小时26分,结构紧凑,但提供了实验文件、Python脚本、数据集和部署配置,适合已经会使用Python、具备基础机器学习知识,并希望把模型从脚本推进到生产环境的开发者、数据科学家和机器学习工程师。
一、认识MLOps与工程基础:
课程先解释MLOps的职责、常见成熟度级别,以及为什么只做好软件持续集成与持续交付还远远不够。模型交付不只是构建代码、运行测试和推送镜像,还需要管理数据、实验、模型版本、特征、部署流程与线上表现。
随后会配置Git、Docker和课程所需的工具链,并使用SQ Lite作为本地存储支持MLflow Model Registry。整个学习过程以本地离线运行为主,无需注册在线账户,能够完整追踪后续实验。你会先认识MLflow的对象结构,例如一次运行包含什么信息、状态如何变化,以及运行标识、参数、指标、标签和模型产物之间的关系,为后面的实操建立清晰概念。
二、实验追踪与版本管理:
版本管理部分从代码、数据和模型3类对象展开。你会使用MLflow Tracking记录训练参数、评估指标和模型文件,把每次实验变成可查询、可比较的运行记录。课程还会与Weights and Biases进行诚实对比,用同一实验展示两套接口在配置、日志和运行生命周期上的差异。选择MLflow的主要原因是它能够完全在本地磁盘运行,后续实验不依赖网络和托管服务。
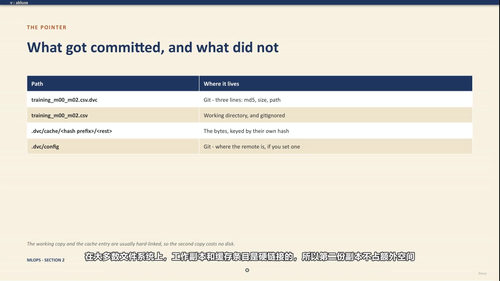
数据版本化实践会处理训练数据与流量数据的组织方式,并结合随课程提供的脚本生成可复现的数据集。模型注册环节则覆盖模型版本、别名、阶段流转和血缘关系,让你知道某个线上模型来自哪次训练、使用了哪些参数,避免出现“线上模型找不到来源”的混乱。
三、构建可靠的训练流水线:
有了版本和实验记录,下一步是把零散脚本串成稳定流程。课程会介绍从脚本到流水线的转变、流水线测试的重要性,以及Apache Airflow和TFX的基本定位,帮助你理解调度、重试、依赖关系与任务状态应该由谁管理。
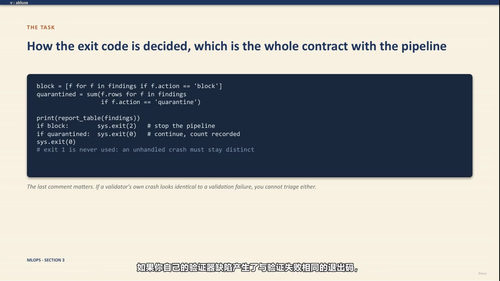
实操部分包含定时重训练有向无环图,以及流水线中的数据验证。你会安排周期性训练任务,检查输入数据是否完整、格式是否符合预期,并将失败信息反馈给流水线,而不是让错误数据悄悄进入模型。Airflow的编排方式与TFX的机器学习流水线思路会放在同一套工程语境中,帮助你根据团队规模、系统边界和自动化需求做选择。
四、搭建自动交付链路:
持续交付部分把模型从流水线接入真实部署环境。课程先讨论机器学习模型部署为什么需要专门的持续集成与持续交付流程,再通过GitHub Actions实现每次提交后自动构建、测试和推送。
你将看到一次端到端自动化部署如何串联代码检查、容器打包、镜像发布、环境部署与验证,减少依赖人工复制文件的环节。部署策略部分还会涉及Kubernetes、金丝雀发布和影子部署。金丝雀发布让新模型先接收少量真实流量,影子部署则把请求复制到新模型但不返回结果,这两种方式都能降低直接全量替换造成的风险。
五、特征存储与一致性:
特征存储章节聚焦训练和服务环境经常出现的特征偏差。同一项特征在离线训练与在线推理时,如果计算逻辑、时间窗口或数据来源不同,模型效果就会悄悄变化。
课程会解释离线存储与在线存储各自承担的职责,并通过特征视图的实践,演示如何集中定义特征、生成训练数据,并让线上服务读取一致的特征定义。这样做不仅减少重复计算,也让特征逻辑更容易审查、复用和维护。
六、监控模型与发现漂移:
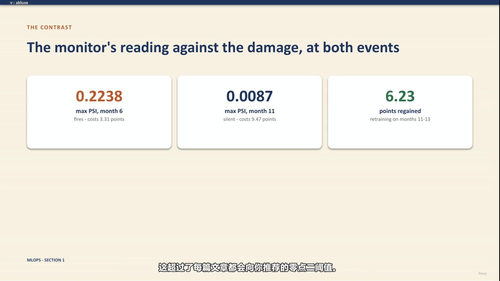
模型上线后,监控不能只看服务是否返回200,也不能只盯准确率。课程会区分数据漂移与概念漂移,说明输入分布变化和预测关系变化为何需要不同的处理方式。阈值设置同样是难点,过于敏感会不断发出误报,过于宽松又可能错过真实问题。
实操会使用实时流量数据检测漂移,并搭建监控面板,把关键指标、分布变化和异常状态集中呈现。课程还会讨论应该为哪些信号设置提醒,让告警对应真实的业务风险,而不是制造每天都要处理的噪声。
七、规模化运营与最终闭环:
课程最后讨论重训练触发条件、计算成本、治理、审计、模型风险和团队职责。自动化不是无限重跑,模型每次上线也需要记录、审批和责任边界。
最终任务是设计一个完整的自动重训练闭环,把数据验证、训练追踪、模型注册、测试、部署、监控和再训练连接起来。你会拿到贯穿各章节的实验脚本与配置文件,逐步完成这条工程链路。
学完这门课程,你获得的不是一份工具清单,而是一套从实验追踪、数据与模型版本管理,到流水线、自动部署、特征复用和线上监控的完整思路。对于希望减少手工操作、提升模型可复现性和交付效率的团队,这套方法可以直接用于搭建更可靠的机器学习生产流程。