资源介绍
视频数量:15个
总时长:1小时28分
课程介绍:
机器学习模型部署实战
模型训练完成,笔记本里的预测结果也很漂亮,可真正让业务系统调用时,问题就接踵而来:模型文件如何保存,输入字段怎样校验,Flask和FastAPI该怎么选,容器与Kubernetes又能解决哪些实际问题。如果你已经会训练模型,却卡在“如何上线”这一步,这套课程会带你把贷款评分模型从本地文件一步步变成可访问、可测试、可扩展的服务。
课程围绕一个12项特征的贷款评分模型展开,不只讲概念,还会提供模型文件、示例数据、代码实验和配置文件。整个学习过程都在本地完成,不需要云平台账号、密钥或额外网络服务,重点始终放在动手验证上。
一、认识模型部署:
课程先解释“离线训练、在线服务”之间的区别。训练阶段可以使用完整数据集和较重的计算资源,但线上服务面对的是实时请求,需要快速、稳定地返回结果。课程会说明课程适合哪些学习者:已经掌握Python基础,能够运行模型并理解输入输出,但对生产部署缺少实践经验。
环境准备部分会安装Docker、Python和本地Kubernetes集群。Docker负责把应用及依赖装进独立容器,Kubernetes集群则用于模拟真实环境中的多节点调度。提前准备好这些工具,后续才能从简单的本地接口逐步走向可扩容的部署方案。
二、把模型变成预测服务:
第一项实操是训练模型并序列化。你会看到模型如何转换为pickle文件保存,也能理解加载模型时必须保持训练环境与运行环境的一致性。示例数据中提供了多种模型产物,便于观察不同文件在加载和预测环节的作用。
随后,课程会创建第一个Flask预测端点,并使用JSON请求提交样本。接口不只负责返回分数,还要处理字段缺失、类型错误和顺序不一致等问题。通过输入验证,可以避免错误数据进入模型后得到看似正常、实际毫无意义的结果。
接着会把Flask接口迁移到FastAPI。迁移过程中,模型本身保持不变,预测逻辑和12个输入特征也不变,真正变化的是服务层。FastAPI会借助Pydantic建立类型化请求契约,自动生成接口文档,并在启动阶段加载模型,避免第一次请求才付出导入和初始化成本。课程还会在Uvicorn以及Gunicorn配合Uvicorn工作进程的环境下运行同一服务,用实验断言确认结果一致。
三、把服务运行得更稳:
从“接口能返回结果”走向“服务扛得住请求”,需要重新审视进程、线程和架构。课程会解释Flask为什么常与Gunicorn配合使用,以及Nginx在反向代理、连接管理、缓冲和请求转发中的位置。
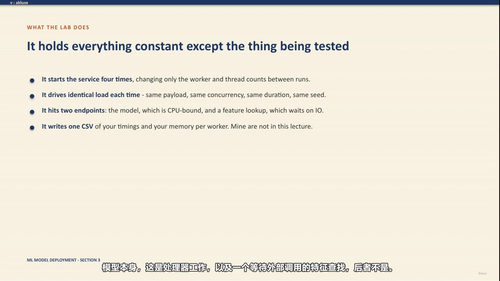
性能实验会固定数据、并发数、持续时间和随机种子,只改变工作进程与线程数量。测试覆盖两个不同类型的端点:一个直接执行模型预测,另一个包含等待外部调用的操作。这样可以观察计算型任务与等待型任务对并发配置的不同需求。
实验还会记录响应时间、吞吐量以及每个工作进程的常驻内存,并通过Locust施加压力,找到当前硬件和服务配置下的性能边界。预热阶段会被单独排除,因为模型导入、缺页读取和缓存冷启动不适合拿来判断长期运行表现。最终得到的不是一条到处照抄的固定公式,而是一套适用于自己机器、模型和业务流量的判断依据。
四、用容器固定运行环境:
Docker部分会从数据科学项目的实际痛点切入:不同机器安装出不同版本、依赖冲突、系统环境难以复制,这些问题都可能让线上结果与本地不一致。课程会把Flask服务制作成镜像,并理解镜像分层、文件变化与构建缓存之间的关系。
容器化之后,依赖清单、Dockerfile和忽略文件共同构成可复现的运行环境。通过Docker Compose,还能在本地同时运行多个服务,模拟更接近实际的系统结构。课程也会讨论镜像仓库以及环境晋级思路,帮助你理解如何把经过测试的镜像从开发环境逐步推向测试与生产,而不是每次上线都临时拼装。
五、部署到Kubernetes:
Kubernetes部分会拆解集群架构,并依次介绍Deployment、Service和Ingress。Deployment负责维持应用副本,Service提供稳定的访问入口,Ingress处理进入集群的流量路由。
你将完成首次集群部署,观察Pod的创建和运行,并学习根据负载调整副本数量。水平自动扩缩容实践会把前面的Locust压测工具用起来,让系统在压力增加时自动增加实例,从而观察扩容行为。
资源请求与限制同样是重点。配置合理,服务才能获得足够内存;配置缺失或不合理,则可能遭遇内存不足、容器被终止等问题。滚动更新和就绪检查部分会解释如何减少发布期间的请求中断,并让新版本在真正可用后再接收流量。
六、更多部署方式与模型优化:
课程还会介绍无服务器推理、托管端点和自托管方案之间的差异。冷启动可能带来额外延迟,而托管服务能够减少部分运维工作,自托管则保留更多控制空间。选择哪一种,取决于流量形态、延迟要求、团队能力和成本结构。
在批处理方面,课程会讨论批量评分流程、流式分析部署和边缘部署。量化实操使用示例模型完成训练后量化,比较模型体积与运行成本,让你在精度、体积和速度之间寻找合适平衡。
七、让服务长期稳定运行:
上线不是终点。日志、指标和链路追踪帮助你判断服务是否健康、请求为何变慢、瓶颈落在哪个环节。安全问题会从攻击面展开,包括接口暴露、输入校验、容器权限和依赖管理。
最后的综合项目要求你以三种方式发布同一个模型,并完成测验答案解析。它像一次完整的交付检查:从模型加载、接口实现,到容器构建、集群部署和流量验证,帮助你把零散知识串成一条真实可执行的工作流程。
完成课程后,你不只是知道几个部署名词,而是能够把训练好的模型包装成稳定接口,处理输入错误,完成压力测试与容器封装,并在Kubernetes中部署、扩容和滚动更新。面对真实业务中的上线需求时,你会有一套可以重复执行、检查和调整的部署方法。