资源介绍
视频数量:341个
总时长:7小时58分
课程介绍:
生产级深度学习流水线实战
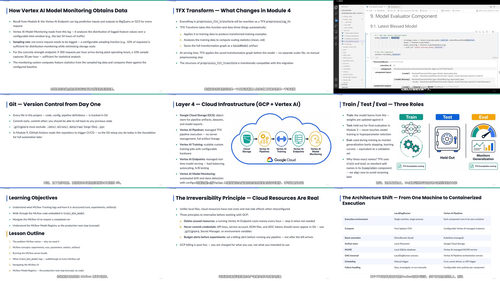
模型训练完成,并不等于项目可以上线。真正棘手的往往出现在模型之后:数据是否一致,训练过程能否复现,模型有没有被错误版本替换,线上服务出现偏差后由谁触发重训。课程以一个真实回归项目为主线,从本地实验一路搭到云端部署、监控和自动再训练,让你看到生产级机器学习系统究竟如何运转。
一、认识生产机器学习生命周期:
课程先拆解机器学习项目的三个阶段:开发、部署和监控,并分析项目经常在哪些环节失控。你会了解手动实验、流水线自动化、持续集成与持续交付之间的差异,也能借助成熟度模型判断团队当前处于哪个阶段。
随后,课程完整介绍 TensorFlow、Keras、MLflow、TFX、Apache Beam、Vertex AI、Docker、TF Serving 和 GitHub Actions 组成的工具链。各工具并非孤立罗列,而是放进同一条数据流中,说明模型、数据、工件和运行记录如何衔接。
案例使用一个包含8项输入特征的回归项目。课程会交代数据来源、目标变量、问题定义方式、评价指标和生产背景,让你先理解业务问题,再决定是否需要深度学习,避免把模型复杂度当成默认答案。
二、搭建可靠的本地开发环境:
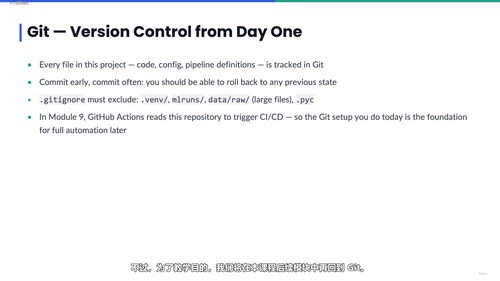
生产实践往往从环境一致性开始。课程讲解 Linux、WSL、Python、Git 和核心依赖包的配置,并提供课程仓库、requirements 文件及数据准备脚本。
这一部分会说明数据如何按 Span 划分。Span 是生产数据按时间或批次形成的可追踪片段,训练集、测试集和评估集分别承担不同职责。实验数据探索也会纳入生产考量,除了观察分布、缺失值和异常值,还要把发现转化为数据约束。特征工程部分重点讲标准化和数据泄漏,强调缩放器必须保存为可复用工件,避免训练与推理采用不同处理规则。
三、开发并追踪深度学习模型:
模型部分从 Sequential API 与 Functional API 的选择讲起,介绍神经网络层、回归输出层和核正则化,再通过 create_dnn_model 函数把结构参数化。随后进入编译、Early Stopping、Reduce Learning Rate on Plateau、数据打乱和训练函数封装。
训练不是结束,MLflow 会记录参数、指标和模型工件,帮助回答“这个结果由哪次实验产生”。评估阶段使用测试集、R Squared 和学习曲线判断模型质量,plot_metric 函数用于可视化训练表现,model.save 则把模型保存为后续服务所需的格式。
四、用 TFX 建立标准流水线:
课程把零散脚本改造成 TFX 流水线,先在 Jupyter Notebook 中逐个运行组件,让你看清每一步产生什么工件、数据怎样流动,而不是只复制一个黑箱示例。
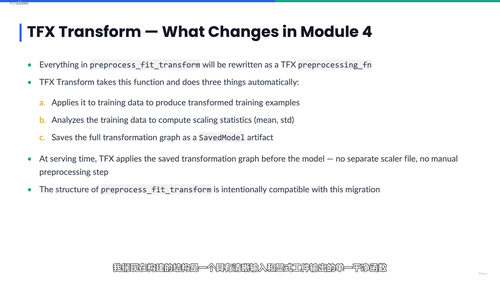
数据摄取部分介绍 ExampleGen、StatisticsGen 和 SchemaGen,并解释 TFRecord 的作用。SchemaGen 会记录数据类型、取值范围和条件规则,ExampleValidator 则按照严重程度检查异常数据,避免有问题的数据悄悄进入训练阶段。Transform 组件负责一致性特征转换,并把转换图保存下来。
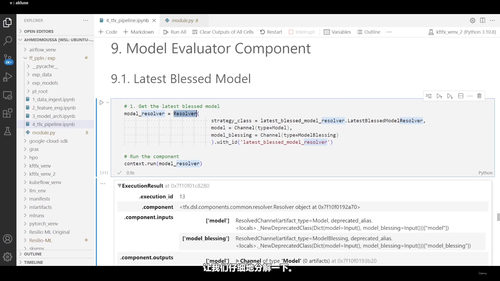
超参数调优使用 Keras Tuner 和贝叶斯优化,搜索空间会直接接入模型构建函数。训练、评估和发布环节覆盖 Trainer、Evaluator、Resolver 与 Pusher。Resolver 根据评估结果选择最新且合格的模型,Pusher 只推送通过验证的版本,从而避免未经检查的模型进入生产链路。
五、编排本地流水线:
掌握组件后,课程进一步构建有向无环图,也就是 DAG。Pipeline 对象会根据组件间的数据依赖自动推导执行顺序,整套定义也能作为受版本控制的工程产物保存。
LocalDagRunner 负责在本地运行流水线,MLMD 保存跨运行历史,构件缓存则避免重复计算。课程会演示缓存命中与未命中的差别,并解释本地编排的边界:它缺少定时触发、失败恢复、监控界面、团队权限与治理能力。由此也能看清从本地实验走向云端平台时,究竟改变了哪些工程条件。
六、迁移到 Google Cloud:
进入云端前,课程先梳理 GCP 项目、API 启用、IAM 权限和最小权限原则,并区分用户账户与服务账户。Google Cloud Storage 承担工件存储,课程会把本地流水线目录映射到存储桶中的 Bucket、Object 和 URI,同时说明数据治理要求。
随后的预检章节会检查基础设施、代码、成本意识以及不可逆操作的边界,避免在权限和资源尚未准备好时仓促提交云端任务。
七、通过 Vertex AI 执行流水线:
课程将 LocalDagRunner 对接到 Vertex AI Pipelines,解释组件隔离、跨度信息和模式文件如何跨本地与云端传递。流水线编译后会生成规范文件,再提交到云端执行。
你还会接触运行编号、运行历史、元数据存储、Dockerfile、依赖清单和 GitHub Actions 工作流。Vertex AI 界面中的 DAG 视图可以直观呈现每次运行的组件状态与工件血缘。定时触发和流水线版本化被放在这里讲解,因为只有进入云端,环境才真正具备持续运行和团队协作的条件。
八、部署模型并管理生产流量:
模型注册表负责保存版本信息,是生产状态的事实来源;Vertex AI Endpoint 则把模型转换为可调用的服务。课程会解释注册表与端点为何必须分离,并介绍端点配置、自动扩缩、部署资源以及请求到达后的完整路径。
实时预测适合需要快速响应的在线业务,批量预测更适合离线处理大量数据,课程会给出选择依据。流量切分还能支持金丝雀发布,让新模型先用小比例流量验证,再逐步扩大影响范围。模型推送云函数可以把新版本注册事件与自动部署连接起来。
九、建立监控和自动重训闭环:
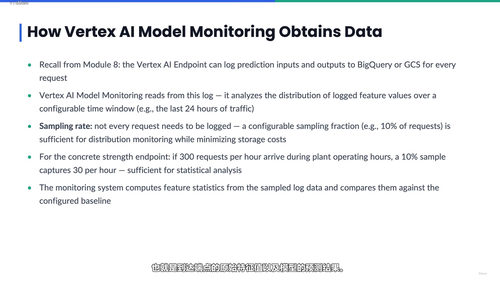
模型上线后,数据漂移、概念漂移和训练服务偏差都会让效果逐渐下滑,其中最麻烦的是没有明显报错却持续失效的静默退化。
Vertex AI Model Monitoring 会以训练数据为基线,检测偏移和漂移,并配置相应告警。告警之后,Pipeline Run 云函数可触发新一轮训练。新模型必须与基线比较,通过 Resolver 验证后才能进入注册表,否则流程会停留在原版本。
课程还会完成 GitHub Actions 与 Vertex AI 的持续集成和持续交付配置,包括服务账户、工作负载身份池、密钥管理和工作流文件。最后通过自定义 TFX 组件、参数化、跨 Span 训练、挑战者模型、缓存重跑、成本归因、模型卡和数据卡等内容,补齐生产系统中的工程细节。
这门课程适合已经会 Python,了解基础机器学习,并希望从模型实验走向工程化交付的开发者;也适合需要接手 TFX、MLflow、Vertex AI 或 MLOps 项目的算法工程师与平台工程师。学完后,你不只是能训练一个模型,还能解释数据如何进入流水线、模型如何被验证和发布、线上表现如何被监控,以及不合格版本为何不会被部署。